Index & Zitationsgraph
Index-Oberfläche
Auf der Seite Synthesis Workbench → Index können Sie den Canonical Reference Index verwalten. Die Index-Oberfläche enthält zwei Unteransichten:
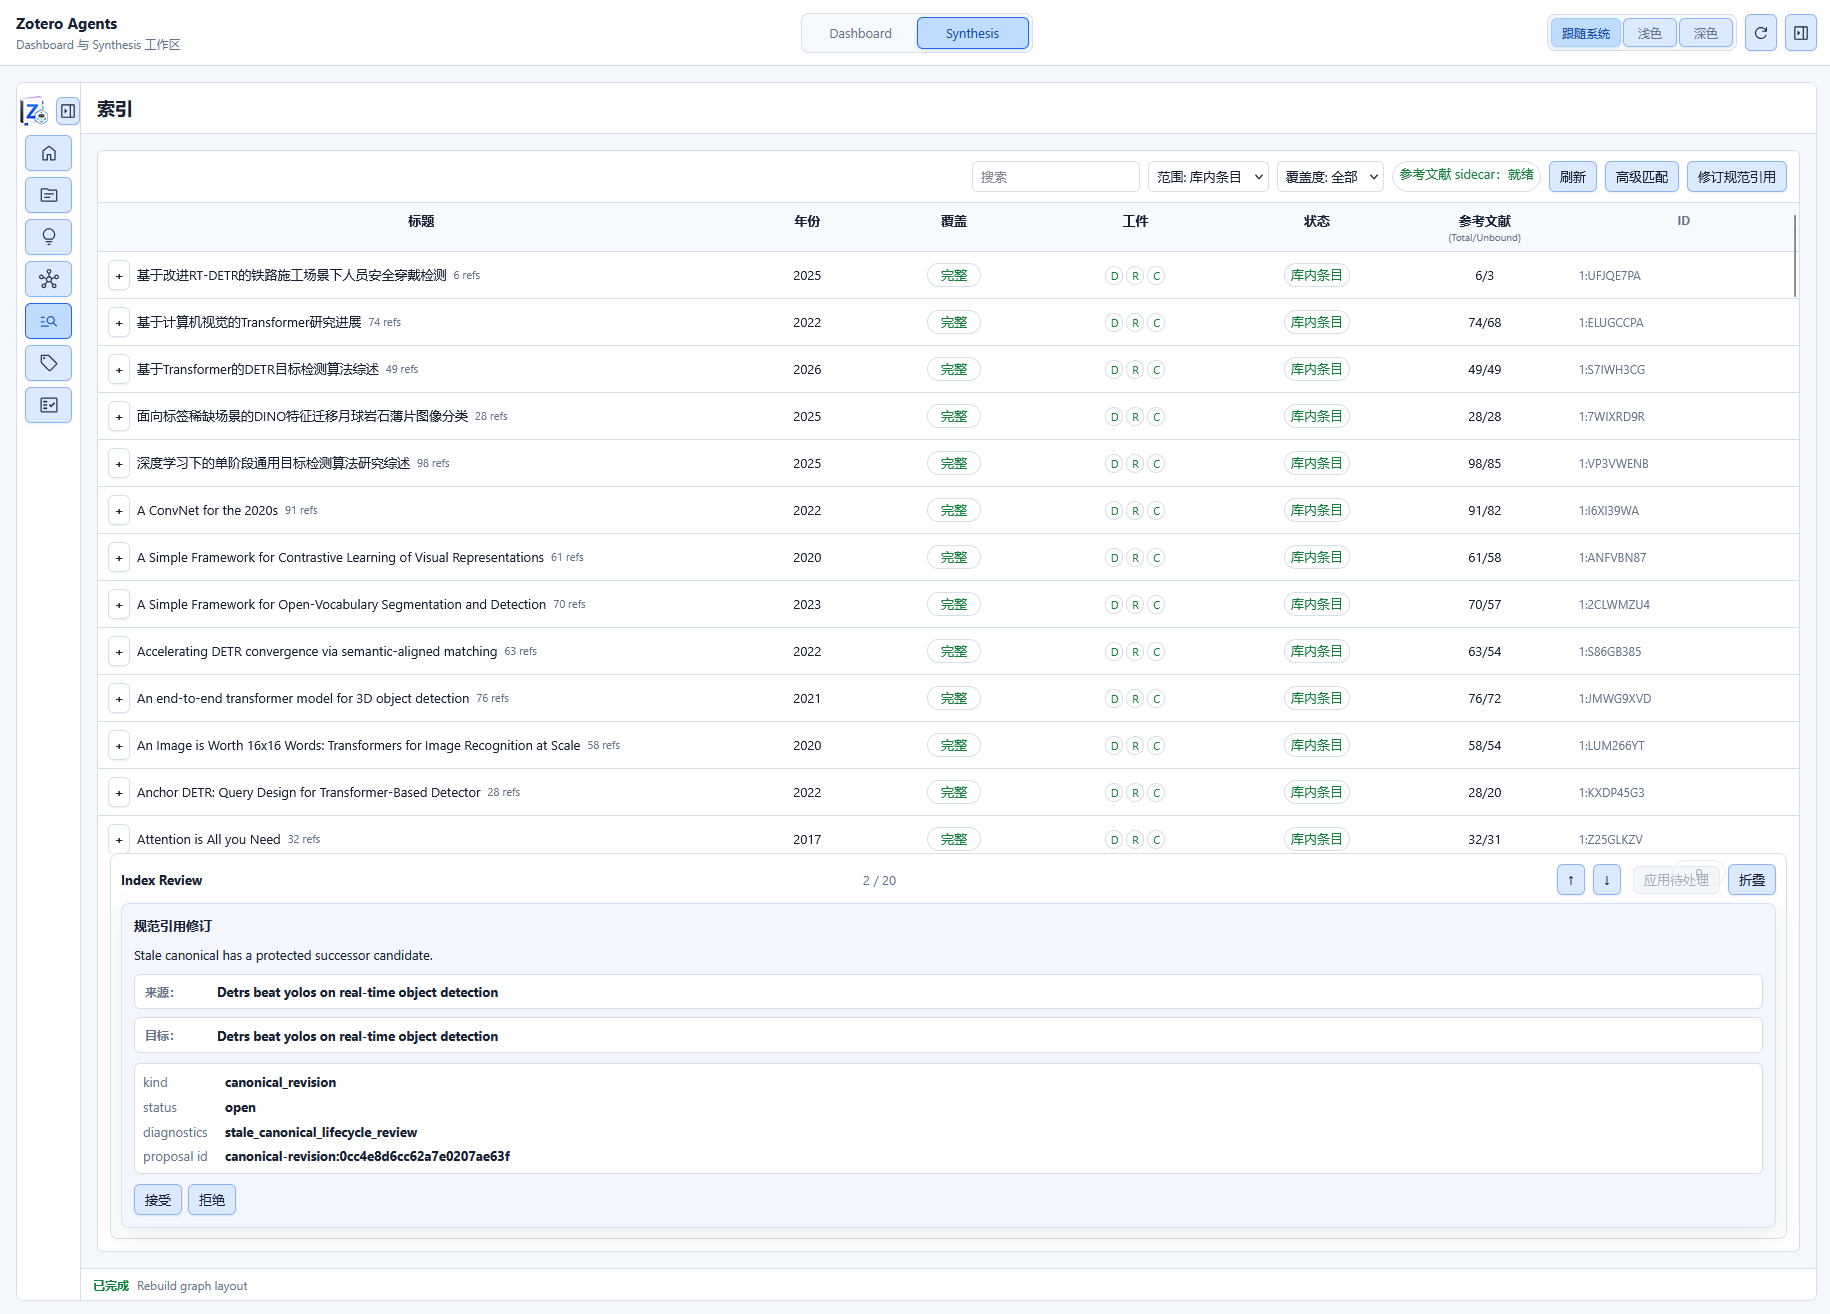
Registry-Ansicht
Zeigt eine Liste aller verfolgten Papers in der Bibliothek, wobei jede Zeile ein Paper und seinen Abdeckungsstatus zeigt:
- Paper-Informationen: Titel, Autor, Jahr
- Abdeckung: Vollständig / Teilweise / Fehlend (Abdeckungsstatus der drei Artefakttypen: Zusammenfassung, Referenzen, Zitationsanalyse)
- Zeile aufklappen: Zeigt beim Aufklappen die Referenzliste des Papers, wobei jede Zitation mit ihrem Bindungsstatus markiert ist (ungebunden / Kandidat / akzeptiert / abgelehnt)
- Filter: Nach Umfang (alle / Bibliothek / zitiert), Abdeckung oder Suche filtern
Canonical-Reference-Ansicht
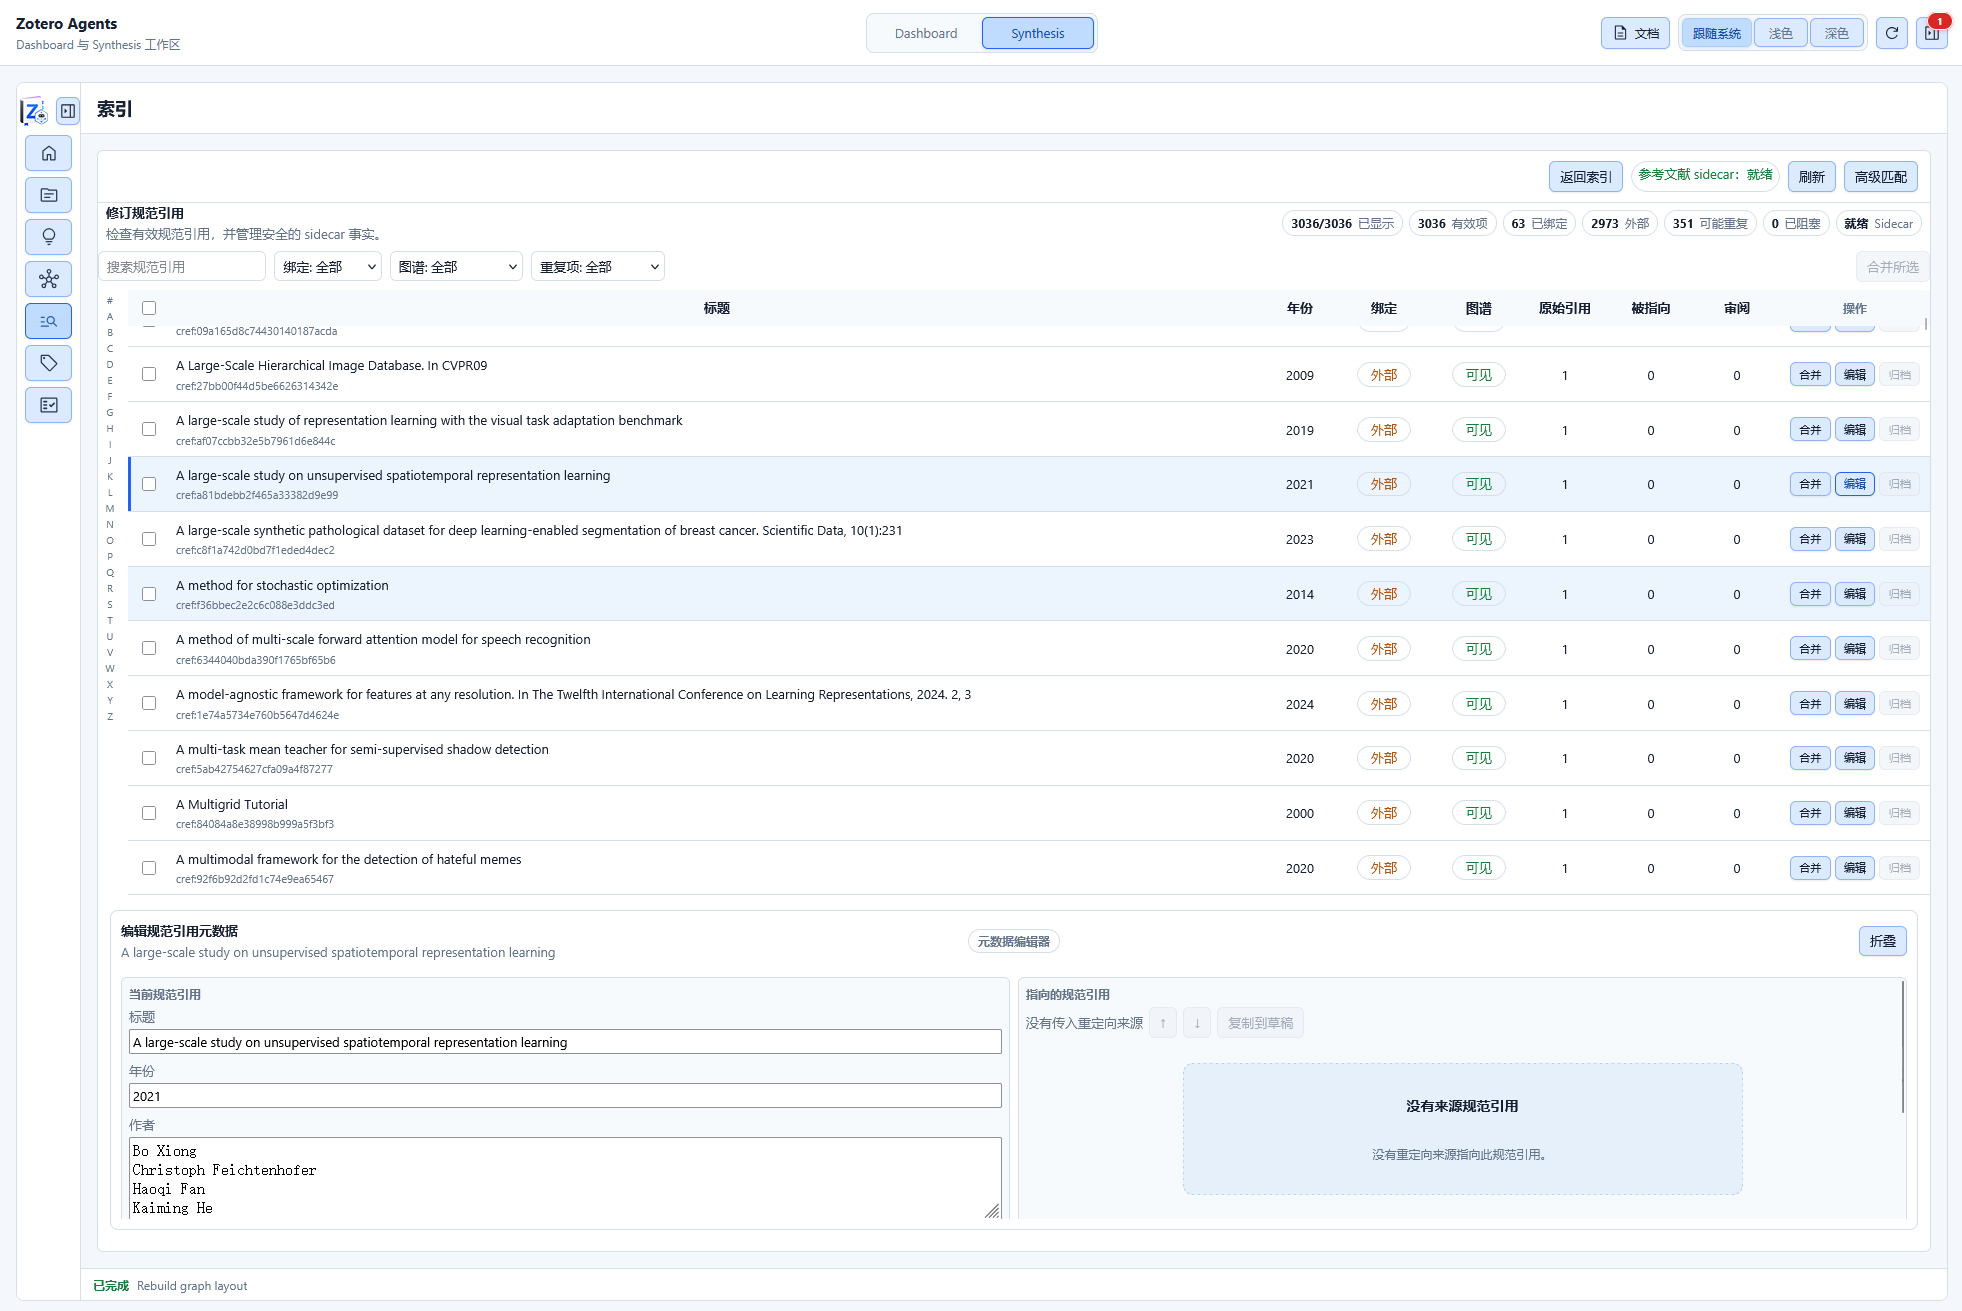
Wird angezeigt, wenn das aktive Indexierungswerkzeug auf "Revise Canonical" umgeschaltet wird:
- Canonical-Reference-Liste: Deduplizierte kanonische Referenzdatensätze
- Suche & Filter: Nach Bindungsstatus, Graph-Sichtbarkeit, Umleitungsstatus oder ob Duplikat-Kandidaten vorhanden sind, filtern
- Aktionen: Metadatenbearbeitung, Duplikat-Referenzen zusammenführen, Umleitungen erstellen, Review-Elemente anzeigen
Canonical Reference Index
Der Canonical Reference Index ist der Kernindex des Synthesis-Systems, der Deduplizierung und Kanonisierung aller Referenzen aus Papers in der Bibliothek durchführt. Er bezieht Roh-Zitationsdaten aus dem Reference Sidecar (siehe Abschnitt "Reference Sidecar" in der Übersicht) und bildet den Index durch Extraktion, Kanonisierung und Match-Bindung.
Funktionen
- Volltextsuche: Über alle kanonisierten Referenzen suchen
- Metadatenbearbeitung: Zitationsdatensatz-Metadaten ändern
- Zusammenführen: Duplizierte Referenzdatensätze zusammenführen (erstellt automatisch Umleitungen)
- Umleiten: Eine Referenz auf einen anderen kanonischen Datensatz zeigen lassen
- Review: Qualitäts-Review-Elemente für Zitations-Matching anzeigen
- Deduplizierung: Potenzielle Duplikat-Referenzen entdecken
Referenzdatensatztypen
| Typ | Beschreibung |
|---|---|
| Gebunden | Mit einem Objekt in der Zotero-Bibliothek verknüpft |
| Extern | Bekannte Literatur, die sich nicht in der aktuellen Zotero-Bibliothek befindet |
| Ungelöst | Aus Referenzen extrahiert, aber noch nicht identifiziert |
Referenz-Matching-Pipeline
Referenz-Matching ist der Prozess der automatischen Herstellung von Assoziationen zwischen aus Papers extrahierten Referenzen und Objekten in der Zotero-Bibliothek. Das System verwendet ein Zweistufenmodell, um Leistung und Genauigkeit in Einklang zu bringen.
Zweistufenmodell
Stufe 1: Leichtgewichtiger Sidecar-Refresh
Läuft bei regulären Operationen (z. B. nach Anwendung einer Zusammenfassung), scannt den Sidecar-Status, vergleicht Zitationsartefakt-Hashes und verarbeitet nur Referenzen, die sich geändert haben. Führt keine fortgeschrittene Deduplizierung oder Indexerstellung aus, sondern nur leichtgewichtige kanonische Zuweisung und Bindung.
- Auslöser: Nach Abschluss der Workflow-Ausführung und dem Schreiben der Artefakte oder über explizite Refresh-Operation
- Umfang: Inkrementell (nur geänderte Referenzen)
- Algorithmus: Einfache Kennungsmatchung (DOI, arXiv, ISBN)
Stufe 2: Fortgeschrittenes Zitations-Matching
Eine explizit ausgelöste Deep-Matching-Operation. Erstellt einen vollständigen Zitations-Match-Index und führt umfassende Matching- und Deduplizierungsalgorithmen aus.
- Auslöser: Manueller Auslöser durch Benutzer, periodische Wartung
- Umfang: Vollständig
- Algorithmus: Multi-Strategie-Matching + Clustering-Deduplizierung
Fortgeschrittenes Zitations-Matching, das Aktualisieren des Index und der Wiederaufbau des Zitationsgraphen sind rechenintensiv. Da Zotero eine Single-Host-Prozessarchitektur verwendet, können diese Operationen während der Ausführung zu kurzen UI-Rucklern führen. Bitte haben Sie Geduld. Dieses Problem soll in einer zukünftigen Architekturrefaktorisierung behoben werden.
Matching-Strategien
| Strategie | Match-Grundlage | Konfidenz | Beschreibung |
|---|---|---|---|
| DOI-Matching | DOI-Kennung | Deterministisch | Exakter Match, automatisch akzeptiert |
| arXiv-Matching | arXiv-ID | Deterministisch | Exakter Match, automatisch akzeptiert |
| ISBN-Matching | ISBN-Nummer | Deterministisch | Exakter Match, automatisch akzeptiert |
| Titel-Ähnlichkeit | Fuzzy-Titel-Matching | Hoch / Mittel / Niedrig | Verwendet standardisierte Titel und Kompakttitel für Ähnlichkeitsberechnung |
| Autor + Jahr | Autorennamen und Erscheinungsjahr | Mittel / Niedrig | Kombiniert Autorennormalisierung und Jahrbereich für Matching |
Konfidenzniveaus
| Niveau | Beschreibung | Empfohlene Aktion |
|---|---|---|
deterministic | Deterministischer Match | Automatisch akzeptieren |
high | Hohe Konfidenz | Akzeptabel |
medium | Mittlere Konfidenz | Überprüfung empfohlen |
low | Niedrige Konfidenz | Erfordert Überprüfung |
review | Erfordert menschliches Urteil | Muss überprüft werden |
Clustering-Deduplizierung
Die fortgeschrittene Matching-Stufe führt eine Clustering-Deduplizierung auf kanonischen Referenzen durch. Der Algorithmus-Prozess:
- Erstellen eines Deduplizierungsdatensatzes für jede kanonische Referenz (einschließlich Eignungsfilterung und bibliografischer Rauschanalyse)
- Paarweiser Vergleich erzeugt Cluster-Kanten (Kennung-Exaktmatch, Titel-Kanonikmatch, Fuzzy-Titel-Match usw.)
- Kanten werden zu Clustern und Unterclustern aggregiert
- Generiert automatische Umleitungen oder Review-Vorschläge zur Deduplizierung
Sicherheitsbedingung: Niedrig-konfidente Matches (z. B. contained_extension_risk) lösen niemals automatische Umleitungen aus und erfordern Benutzerüberprüfung.
Review-Oberfläche
Im Review-Hub können Sie Zitations-Match-Vorschläge anzeigen und verarbeiten und sie einzeln akzeptieren oder ablehnen.
Zitationsgraph
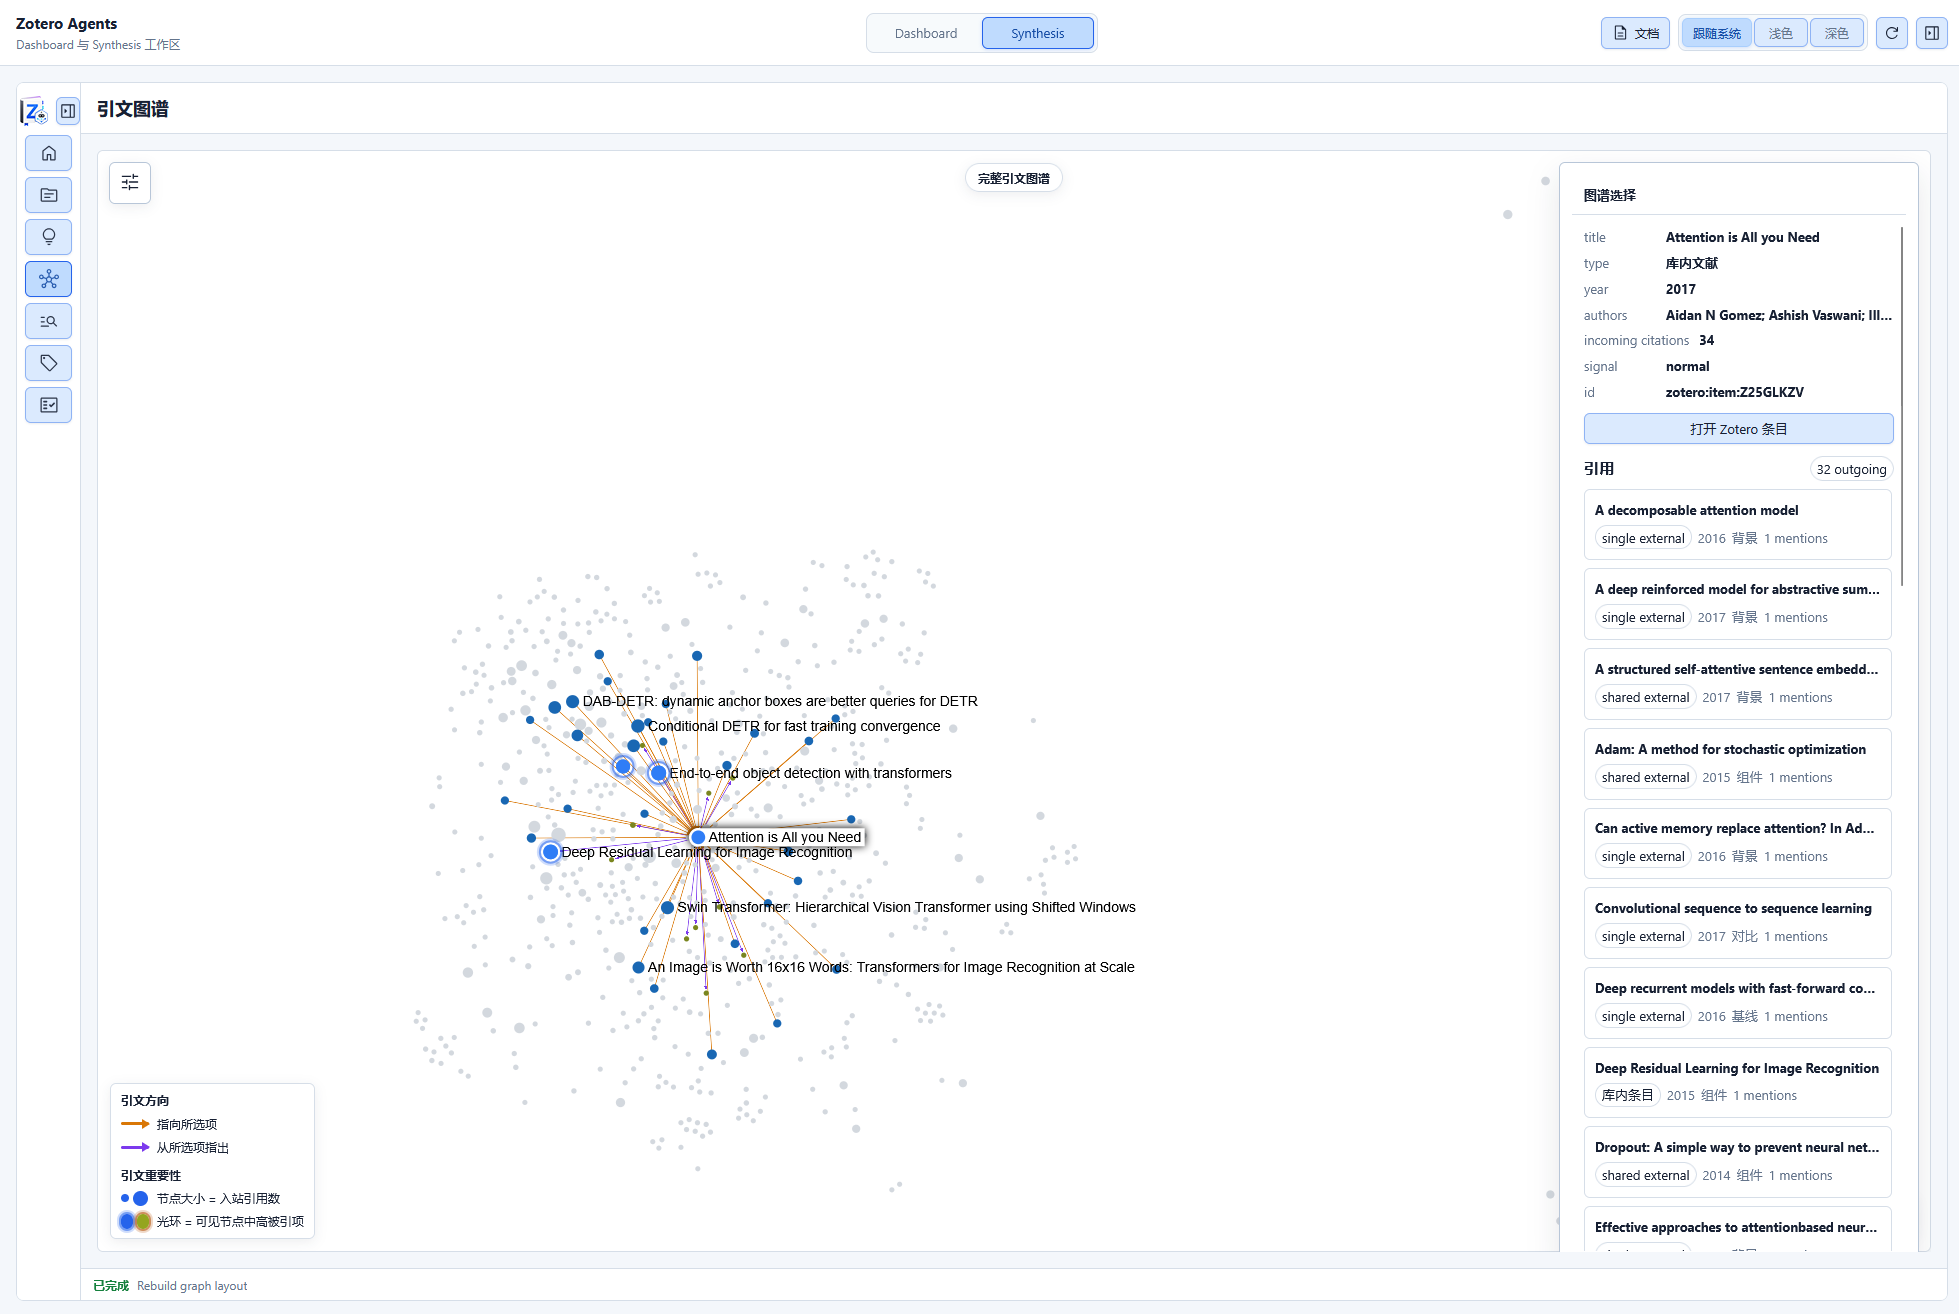
Der Zitationsgraph visualisiert die Papers in der Bibliothek und ihre Referenzen als Netzwerkgraph. Die Graphdaten werden als SQLite-Projektion erstellt und können ein gewisses Maß an Datenveraltetheit tolerieren (kein Echtzeit-Spiegelbild).
Knotentypen
| Knoten | Farbe | Beschreibung |
|---|---|---|
library_paper | Blau | Papers, die sich bereits in der Zotero-Bibliothek befinden |
external_reference | Grün | Bekannte Referenzen, die sich nicht in der Bibliothek befinden |
unresolved_reference | Grau | Extrahierte, aber nicht identifizierte Referenzen |
Kanteninformationen
Jede Zitationskante enthält:
- mention_count: Anzahl der Zitierungen
- primary_role: Primäre Zitationsrolle (z. B. Hintergrund, Vergleich, Unterstützung, Kontrast)
- aux_roles: Liste der Hilfsrollen
- role_evidence: Grundlage für die Rollenbestimmung
Graph-Metriken
Der Zitationsgraph kann verschiedene Metriken berechnen, um Kernpapers und einflussreiche Werke zu identifizieren:
| Metrik | Beschreibung |
|---|---|
| Zitationsanzahl | Gesamtanzahl der Zitierungen eines Papers |
| PageRank | Knoten-Wichtigkeitsscore basierend auf der Graphstruktur |
| Foundation Score | Grad, in dem es als Grundlagenwerk im Feld dient |
| Frontier Score | Grad, in dem es Grenzarbeit repräsentiert |
Visualisierungs-Layouts
| Layout | Beschreibung | Anwendungsfall |
|---|---|---|
| Force (Force-Directed) | d3-force-Layout | Gesamtstruktur erkunden |
| Radial | Um einen ausgewählten Knoten expandieren | Zitationsnetzwerk eines Papers analysieren |
| Components | Nach verbundenen Komponenten gruppieren | Unabhängige Zitationscluster entdecken |
Interaktive Operationen
- Zoom / Pan: Den Graphen frei durchsuchen
- Hover: Knotenbeschriftungen und Grundinformationen anzeigen
- Klick auf Knoten: Das entsprechende Paper-Objekt in Zotero öffnen
- Filter: Angezeigte Zitationen nach Rolle, Thema oder Knotentyp filtern
- Low-Signal-Zitationen umschalten: Kanten mit niedriger Zitationsanzahl ein-/ausblenden
- Tiefenregler: Die Expansionstiefe des Zitationsnetzwerks steuern
Themenfilterung
Sie können den Zitationsgraphen nach Thema filtern, um nur Papers und Zitationsbeziehungen anzuzeigen, die mit bestimmten Themen zusammenhängen. Themenbereiche werden im Graphen mit verschiedenen Farben und Gruppierungen angezeigt.
Nächste Schritte
- Review-Zentrale – Zitations-Match- und Deduplizierungsvorschläge prüfen
- Themensynthese erstellen – Themenanalysen basierend auf Zitationsnetzwerken erstellen
- Home-Dashboard – Bibliothekseinblick-Metriken anzeigen
- WebDAV Sync – Zitationsbindungsdaten geräteübergreifend synchronisieren