Deep Reading
Propósito
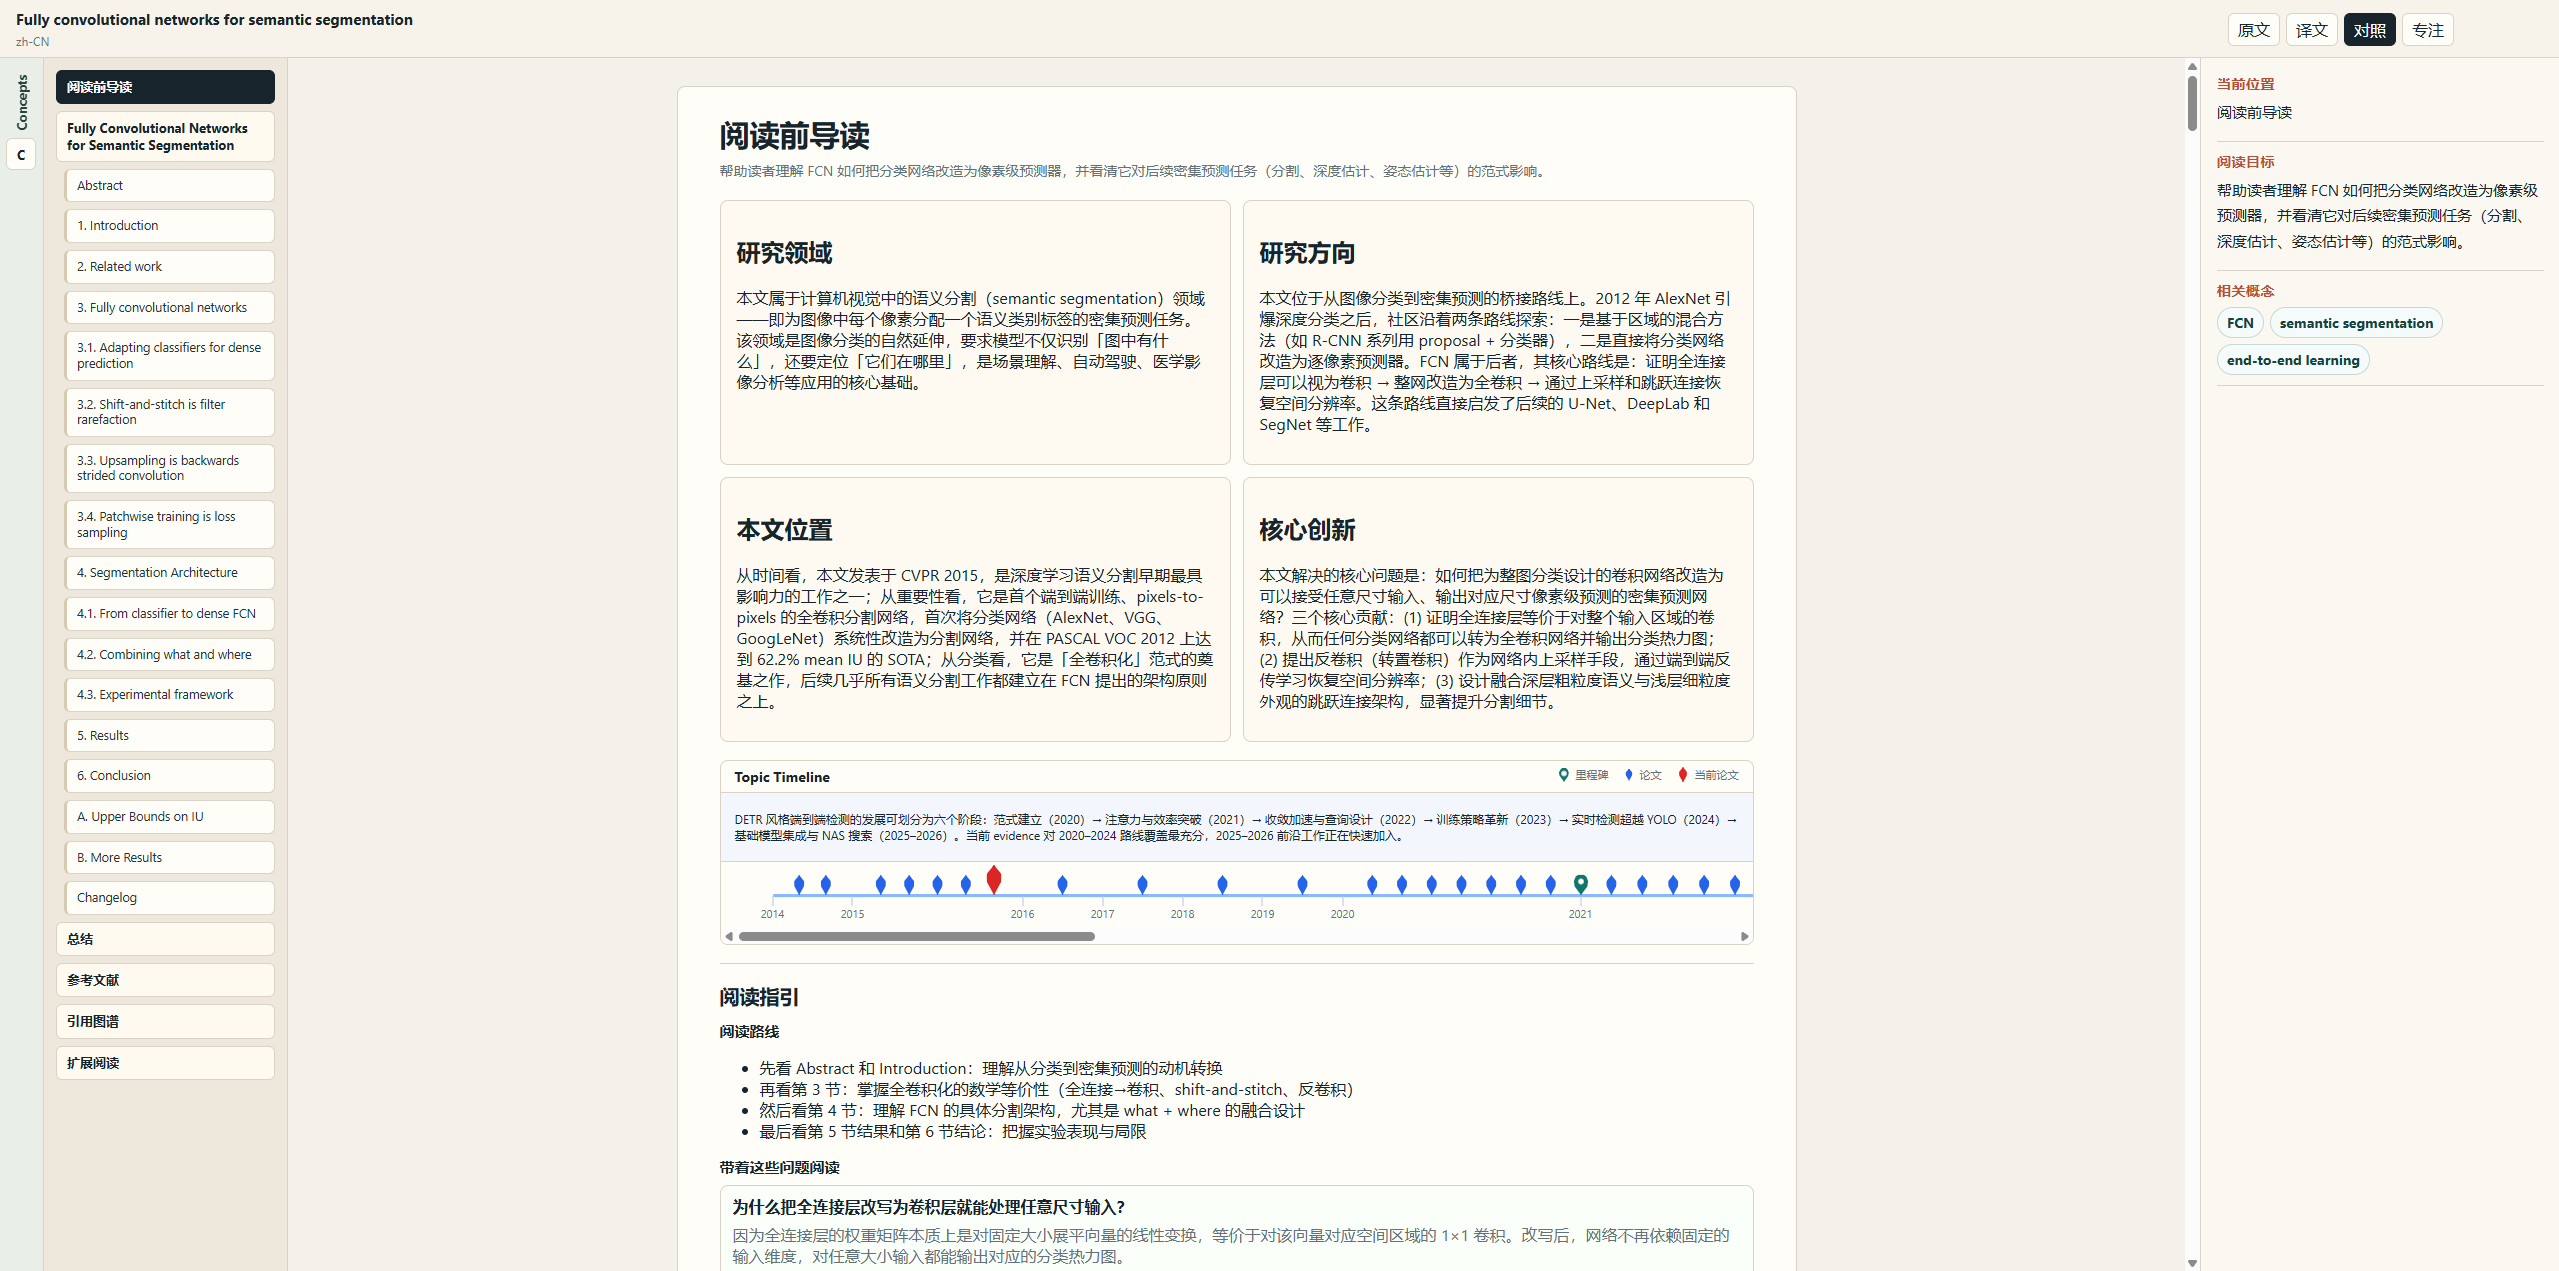
Realizar una lectura profunda de un artículo, generando una vista de análisis de lectura estructurada y multiperspectiva. Extrae automáticamente la estructura de capítulos, conceptos clave y referencias, admite traducción párrafo por párrafo y produce un documento HTML de lectura independiente.
Casos de uso
- Lectura profunda sistemática de un artículo importante
- Obtener un análisis completo que incluya anotaciones por capítulo, conceptos clave y lecturas adicionales
- Necesidad de lectura bilingüe en paralelo (texto original + traducción al idioma objetivo)
Restricciones de entrada
| Tipo de restricción | Descripción |
|---|---|
| Unidad de entrada | Adjunto |
| Tipos aceptados | text/markdown, text/x-markdown, text/plain, application/pdf |
| Límite por elemento padre | Como máximo 1 adjunto |
Métodos de activación
- Seleccionar directamente un adjunto PDF o Markdown
- Seleccionar el elemento padre, y el complemento expandirá automáticamente su primer adjunto elegible
Flujo de ejecución
El flujo de trabajo Deep Reading es un pipeline de procesamiento totalmente automático en múltiples etapas que no requiere intervención del usuario:
Duración estimada
| Tamaño del archivo | Tiempo estimado |
|---|---|
| Artículo corto (≤10 páginas) | 8-12 minutos |
| Estándar (10-30 páginas) | 12-18 minutos |
| Artículo largo (30+ páginas) | 18-25 minutos |
Este flujo de trabajo implica procesamiento en múltiples etapas (orientación → enriquecimiento → traducción → organización → renderizado), lo que lo convierte en el flujo de análisis de artículos individuales de mayor duración.
Recomendación de modelo
🟡 Se recomiendan modelos con fuerte comprensión textual. Este flujo de trabajo requiere análisis profundo multicapa del artículo (estructura, conceptos, lógica argumentativa), lo que impone altas exigencias a la comprensión semántica del modelo. Si se dispone de capacidad de delegación de subagentes, las etapas se pueden ejecutar en paralelo, reduciendo significativamente el tiempo total.
Resultados
1. Fase de preparación
   └── Subir archivo fuente, generar source_bundle.zip
       └── Contiene texto original, imágenes y referencias existentes

2. Orientación y recopilación de contexto
   └── Analizar estructura y metadatos del texto original
       └── Recopilar contexto relacionado a través de Host Bridge

3. Enriquecimiento de lectura
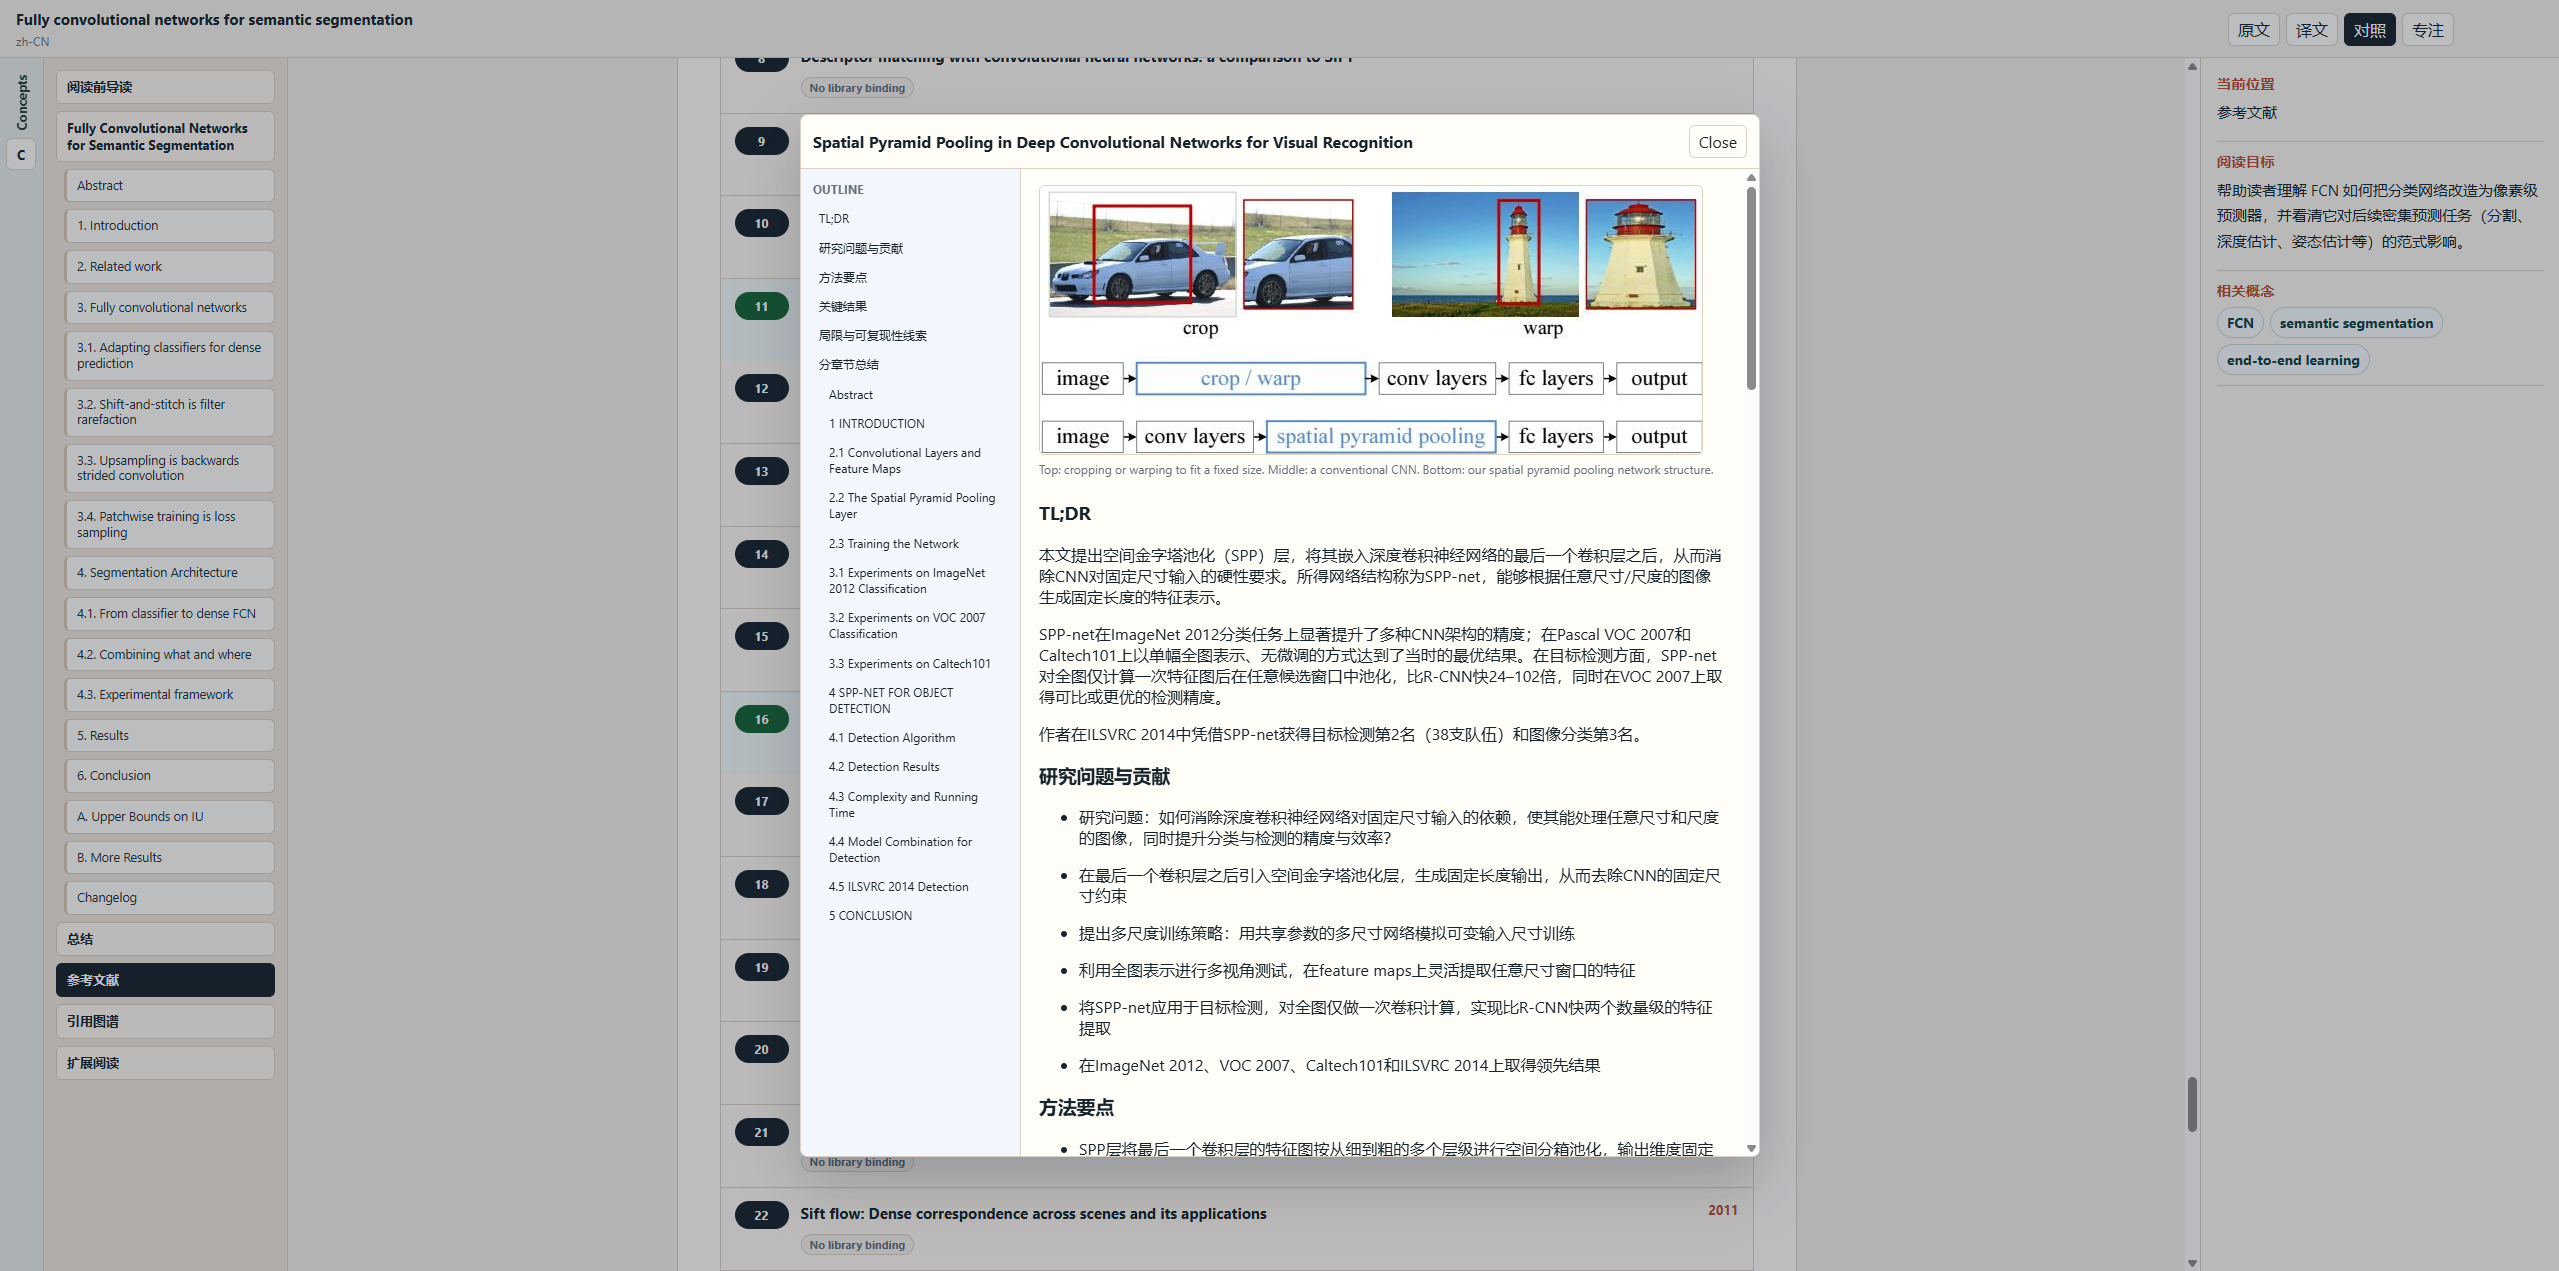
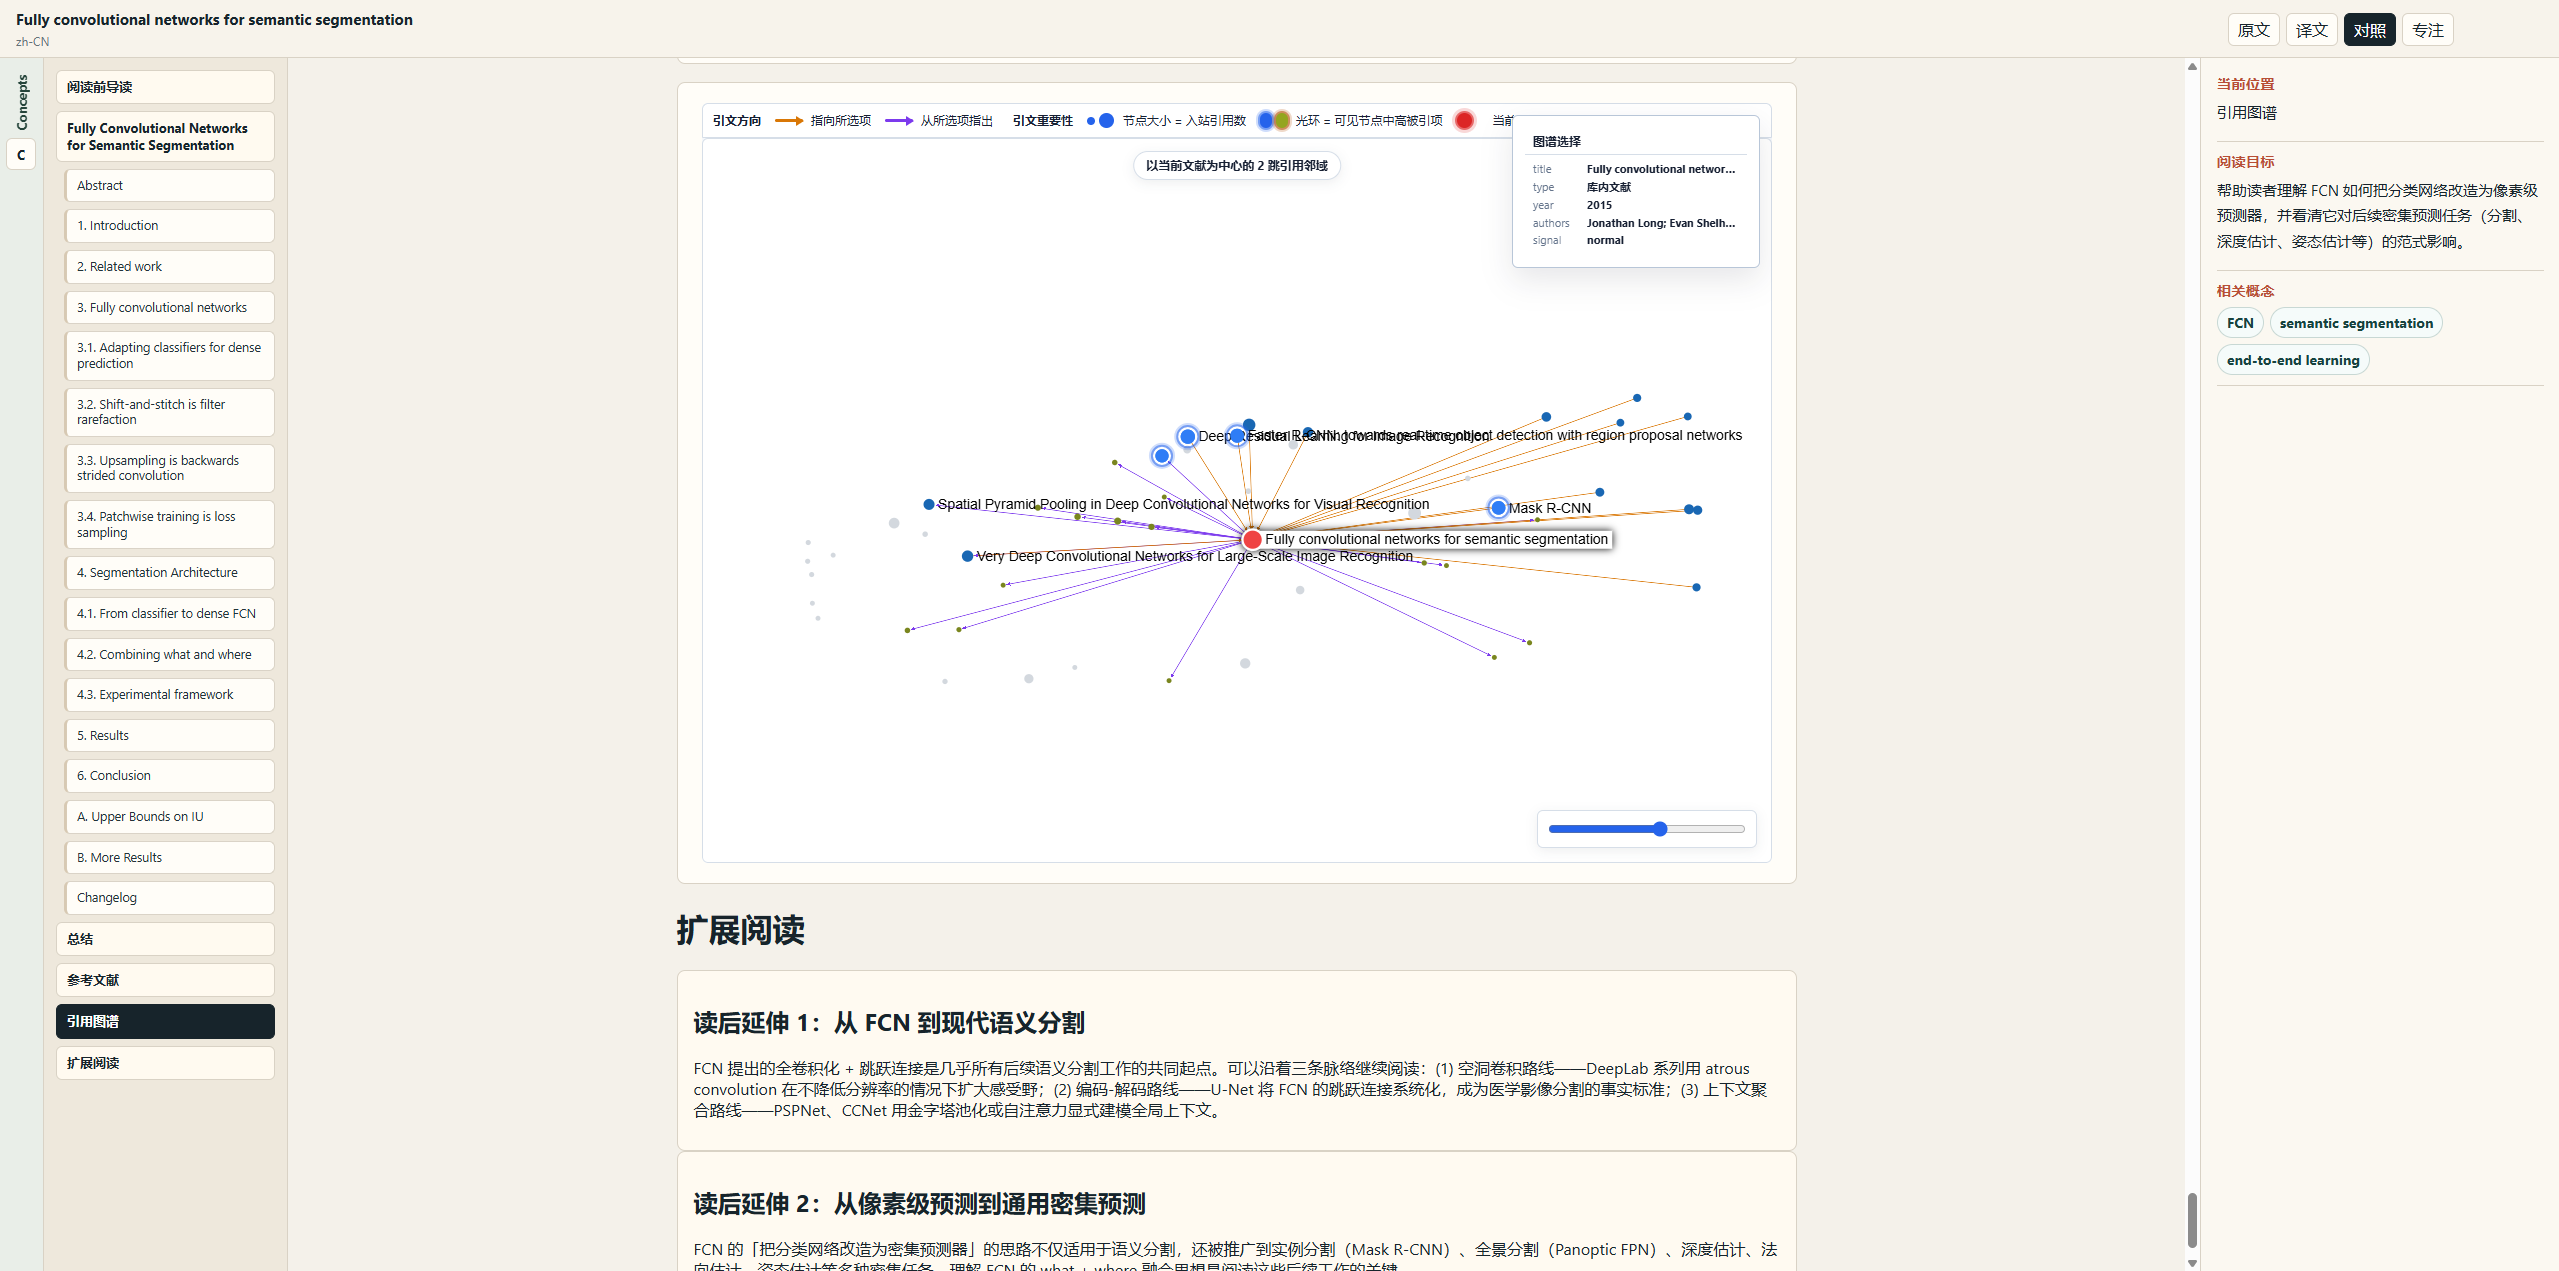
   └── Generar anotaciones por capítulo, conceptos clave, análisis de referencias
       └── Vistas de resumen y lecturas adicionales

4. Traducción bloque por bloque
   └── Normalizar traducción por bloques estables
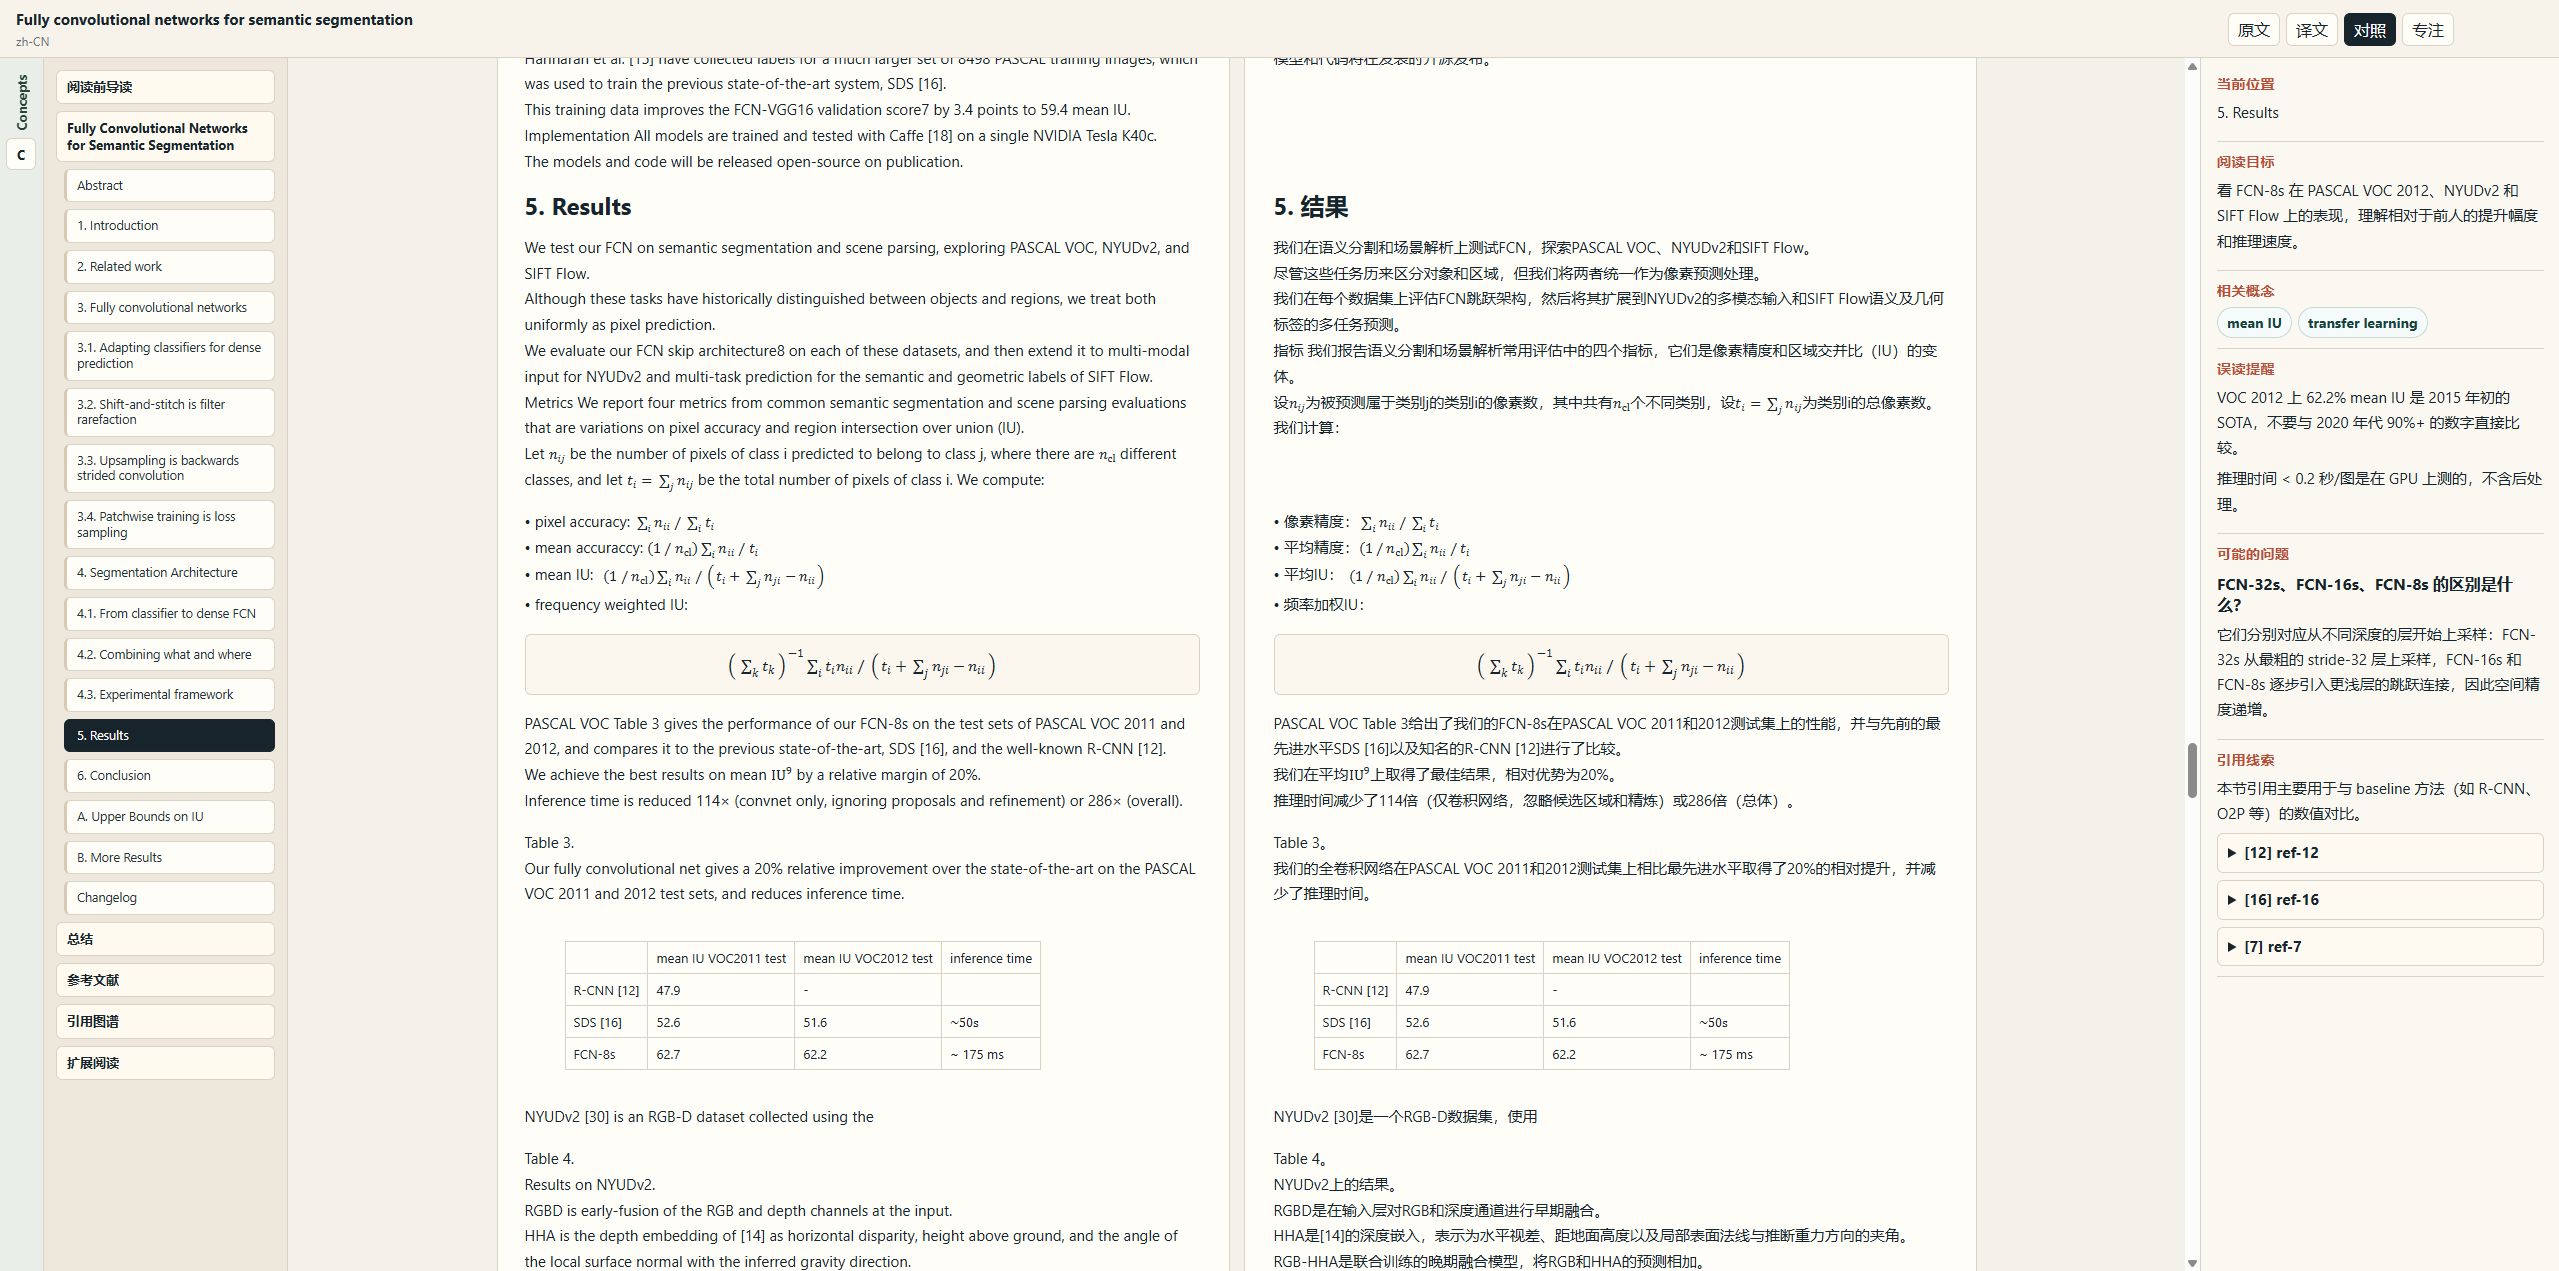
       └── Generar vista de traducción bilingüe en paralelo

5. Renderizado final
   └── Integrar todas las vistas de análisis
       └── Renderizar como archivo HTML independiente
Artefactos de salida
Una vez completada la ejecución, se crea un adjunto vinculado que apunta al archivo HTML generado bajo el elemento padre:
- Formato: Archivo HTML independiente (se puede abrir en un navegador)
- Contenido: Vista completa de lectura profunda que incluye estructura del texto original, anotaciones por capítulo, análisis de conceptos, referencias, traducciones bilingües, etc.
- Ciclo de vida: Cada ejecución sobrescribe y actualiza
Parámetros
| Parámetro | Tipo | Descripción | Valor predeterminado |
|---|---|---|---|
target_language | string | Idioma objetivo | zh-CN |
Valores disponibles: zh-CN, en-US, ja-JP, ko-KR, de-DE, fr-FR, es-ES, ru-RU. También se admite entrada personalizada.
Dependencias
- Backend: Backend ACP (requiere soporte del protocolo ACP)
- Configuración del backend: Configurar un backend de tipo ACP en el gestor de backends
Flujos de trabajo relacionados
- Literature Analysis — Generar resúmenes de literatura y análisis de citas automáticamente
- Interactive Literature Explainer — Dialogar con la IA para comprender la literatura en profundidad