Deep Reading
Objectif
Effectuer une lecture approfondie d'un article, en générant une vue d'analyse de compréhension de lecture structurée et multi-perspective. Extrait automatiquement la structure des chapitres, les concepts clés et les références, prend en charge la traduction paragraphe par paragraphe, et produit un document HTML de lecture autonome.
Cas d'Usage
- Lire en profondeur de manière systématique un article important
- Obtenir une analyse complète incluant des annotations de chapitres, des concepts clés et des lectures complémentaires
- Besoin de lecture parallèle bilingue (texte original + traduction dans la langue cible)
Contraintes d'Entrée
| Type de Contrainte | Description |
|---|---|
| Unité d'Entrée | Pièce jointe |
| Types Acceptés | text/markdown, text/x-markdown, text/plain, application/pdf |
| Limite par parent | Au maximum 1 pièce jointe |
Méthodes de Déclenchement
- Sélectionner directement une pièce jointe PDF ou Markdown
- Sélectionner la notice parente, et le plugin déploiera automatiquement sa première pièce jointe éligible
Flux d'Exécution
Le workflow Deep Reading est un pipeline de traitement entièrement automatique en plusieurs étapes ne nécessitant aucune intervention utilisateur :
Durée Estimée
| Taille du Fichier | Durée Estimée |
|---|---|
| Article court (≤10 pages) | 8-12 minutes |
| Standard (10-30 pages) | 12-18 minutes |
| Article long (30+ pages) | 18-25 minutes |
Ce workflow implique un traitement en plusieurs étapes (guidage → enrichissement → traduction → organisation → rendu), ce qui en fait le workflow d'analyse d'article unique le plus long.
Recommandation de Modèle
🟡 Des modèles avec une forte compréhension du texte sont recommandés. Ce workflow nécessite une analyse approfondie multi-couches de l'article (structure, concepts, logique argumentative), ce qui place la barre haute en termes de compréhension sémantique du modèle. Si la capacité de délégation à des sous-agents est disponible, les étapes peuvent être exécutées en parallèle, réduisant significativement le temps total.
Sorties
1. Phase de Préparation
   └── Téléverser le fichier source, générer source_bundle.zip
       └── Contient le texte original, les images et les références existantes

2. Guidage et Collecte de Contexte
   └── Analyser la structure du texte original et les métadonnées
       └── Collecter le contexte associé via Host Bridge

3. Enrichissement de la Lecture
   └── Générer des annotations de chapitres, des concepts clés, une analyse des références
       └── Vues de résumé et de lectures complémentaires

4. Traduction Bloc par Bloc
   └── Normaliser la traduction par blocs stables
       └── Générer une vue de traduction parallèle bilingue

5. Rendu Final
   └── Intégrer toutes les vues d'analyse
       └── Rendre en tant que fichier HTML autonome
Artefacts de Sortie
Une fois l'exécution terminée, une pièce jointe liée pointant vers le fichier HTML généré est créée sous la notice parente :
- Format : Fichier HTML autonome (peut être ouvert dans un navigateur)
- Contenu : Vue complète de lecture approfondie incluant la structure du texte original, les annotations de chapitres, l'analyse des concepts, les références, les traductions bilingues, etc.
- Cycle de vie : Chaque exécution écrase et met à jour
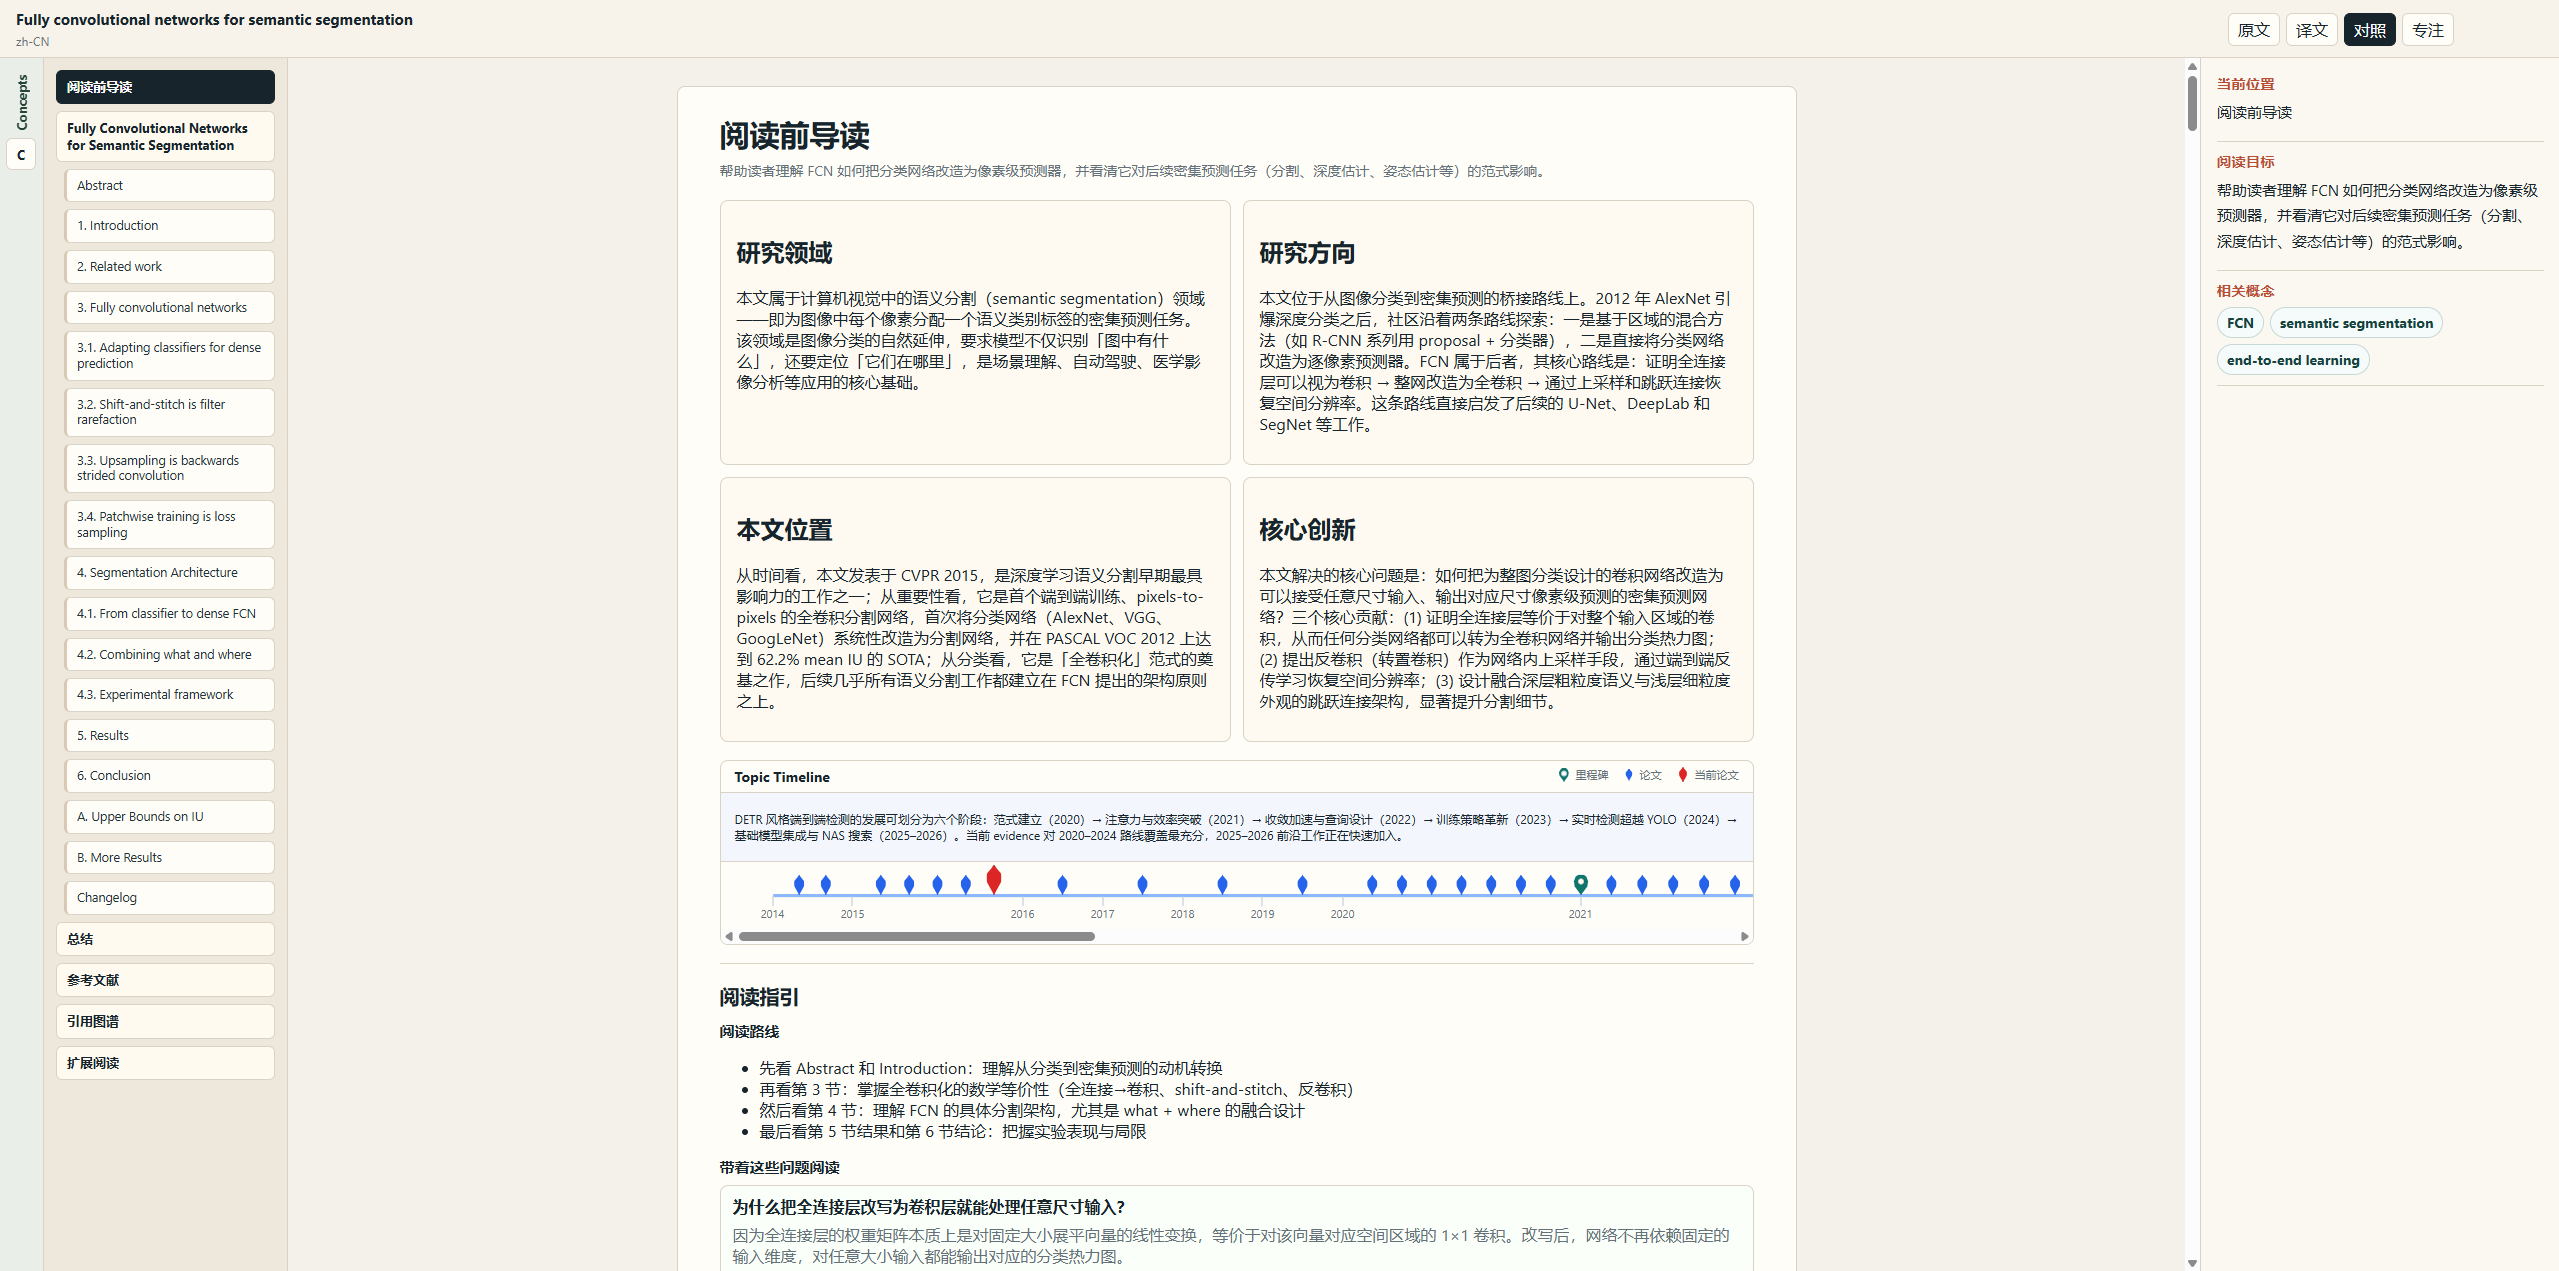
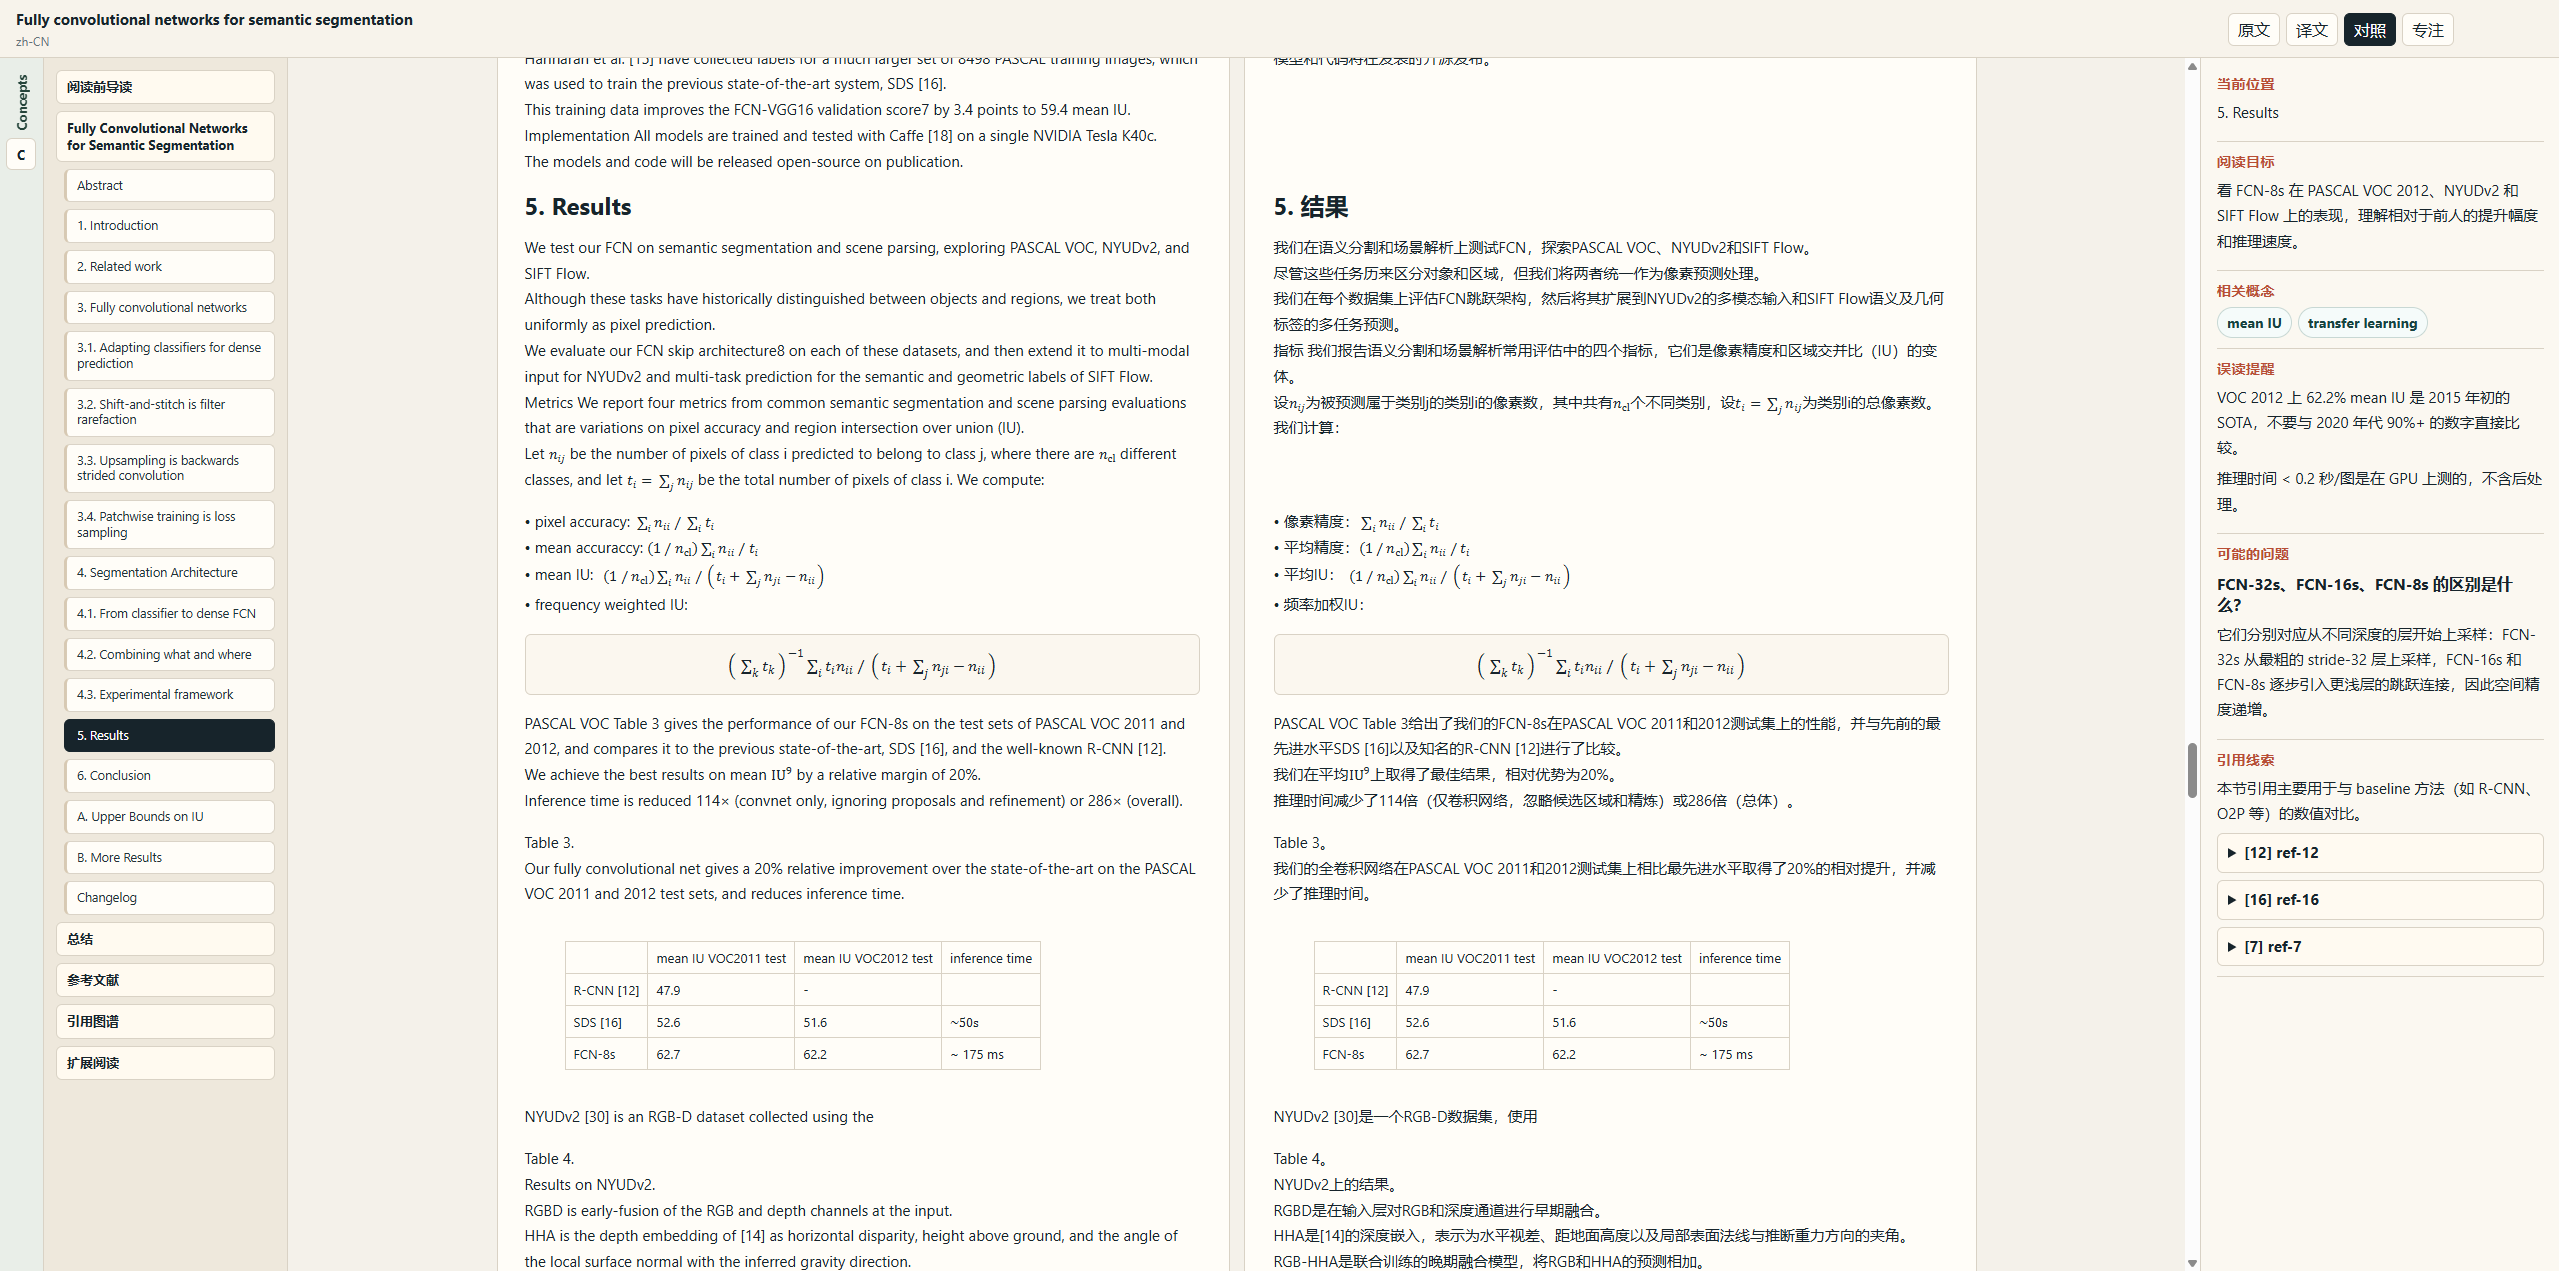
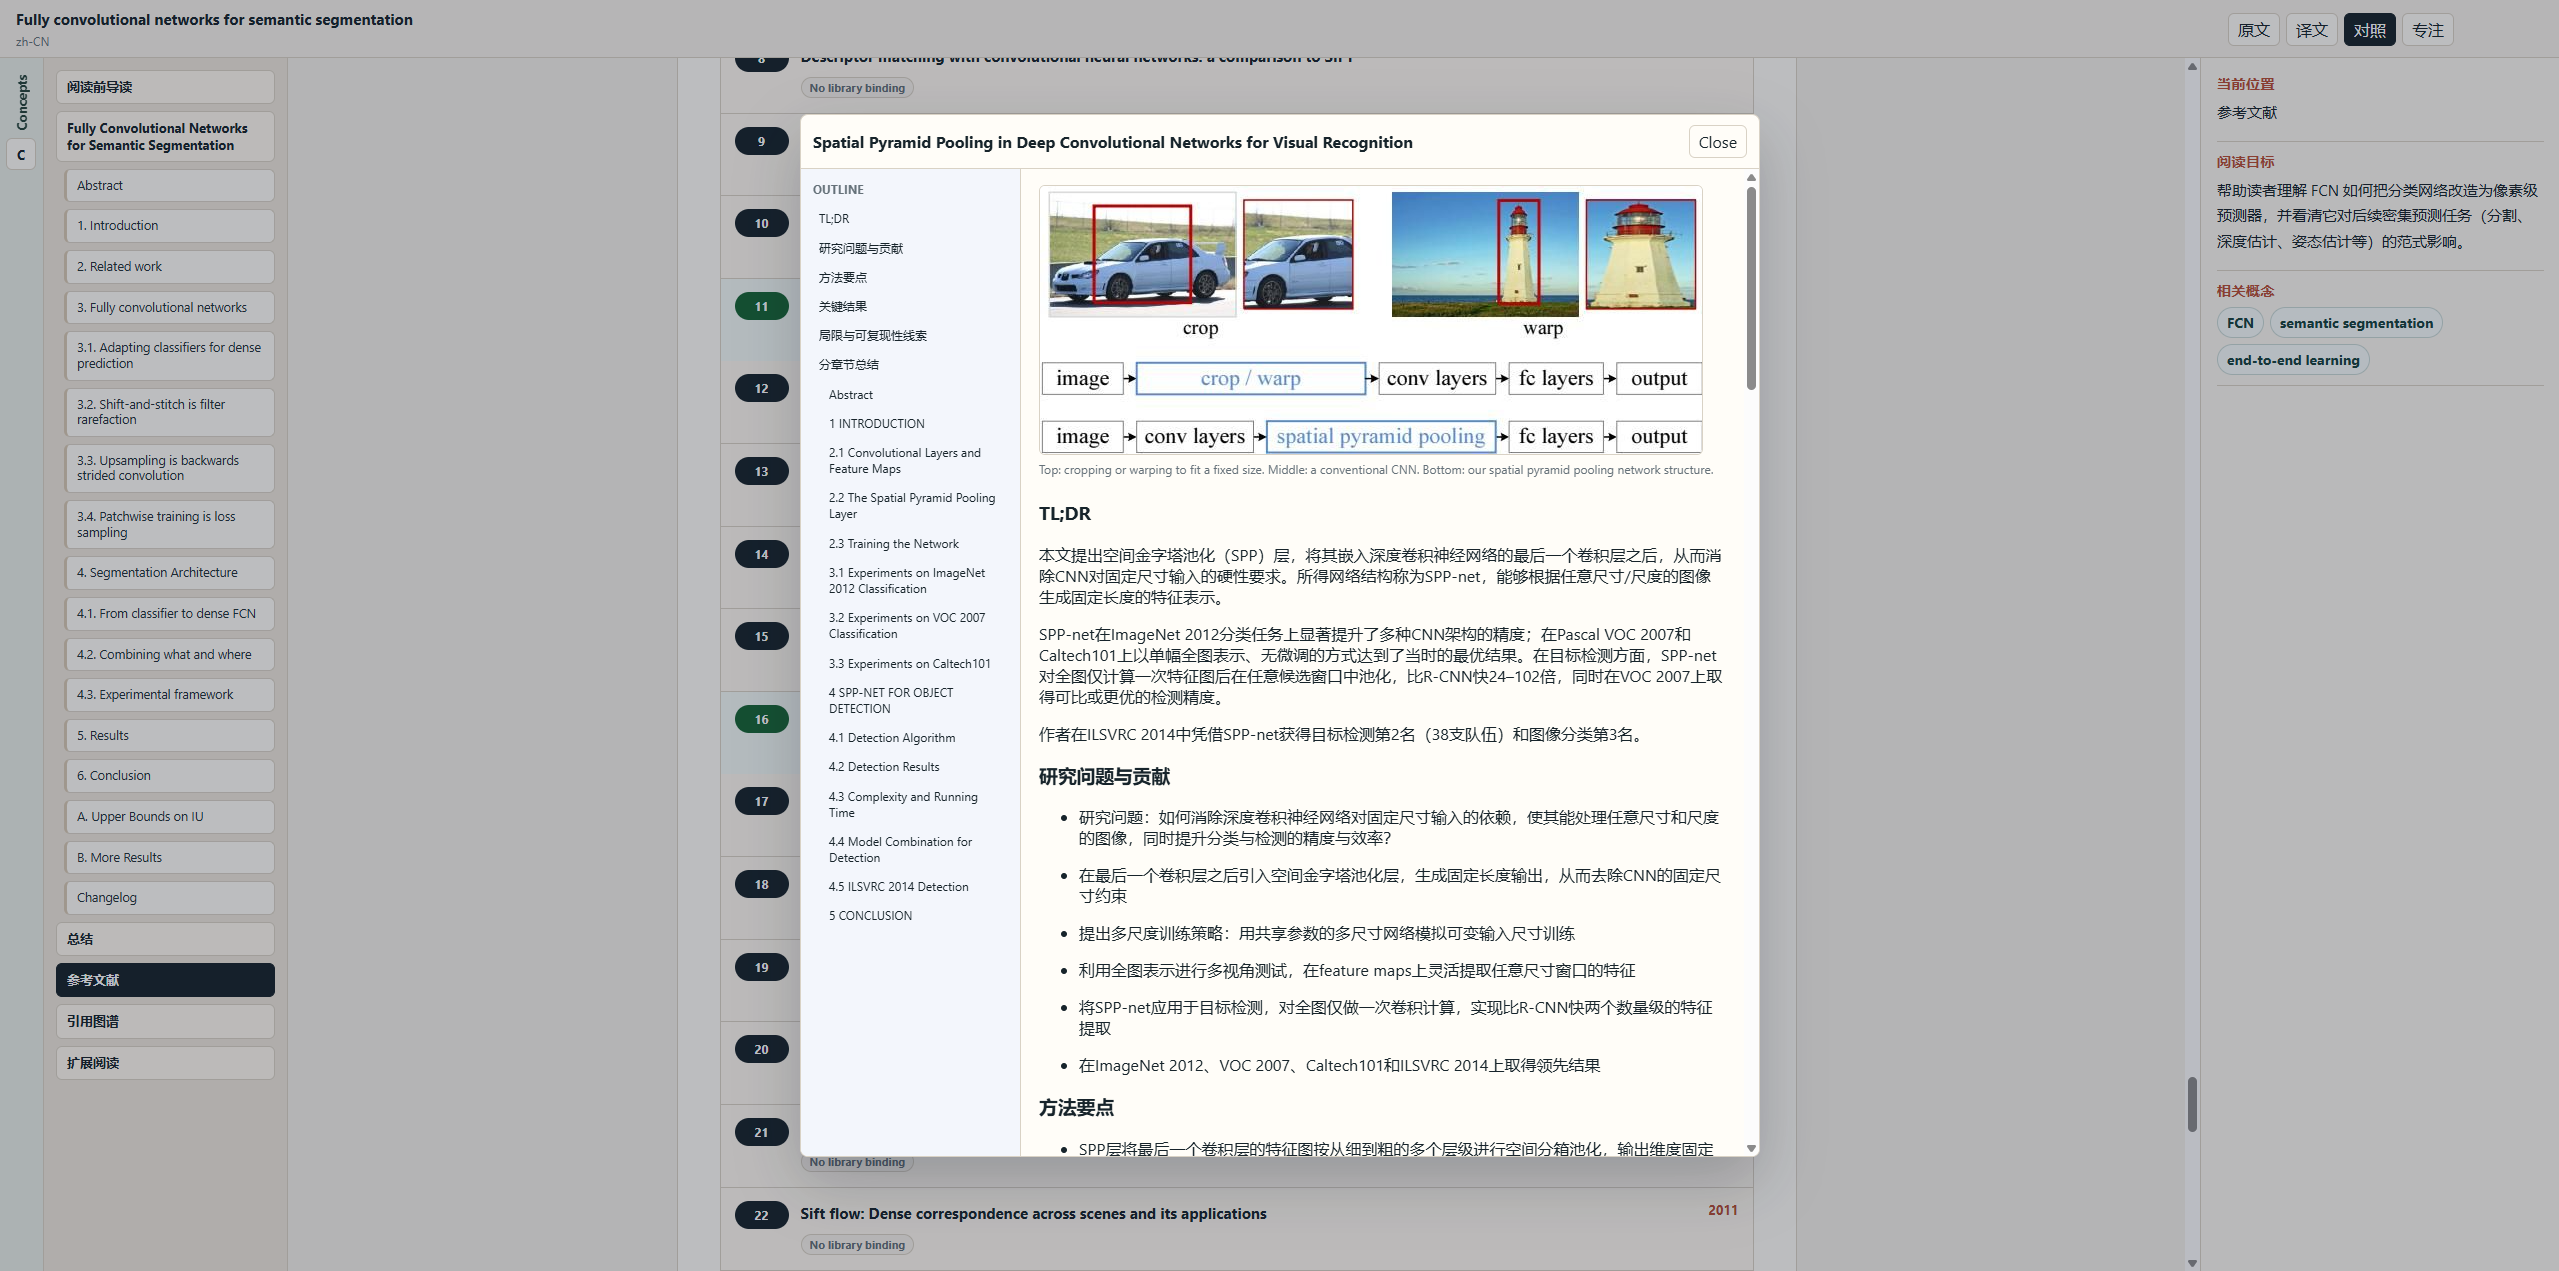
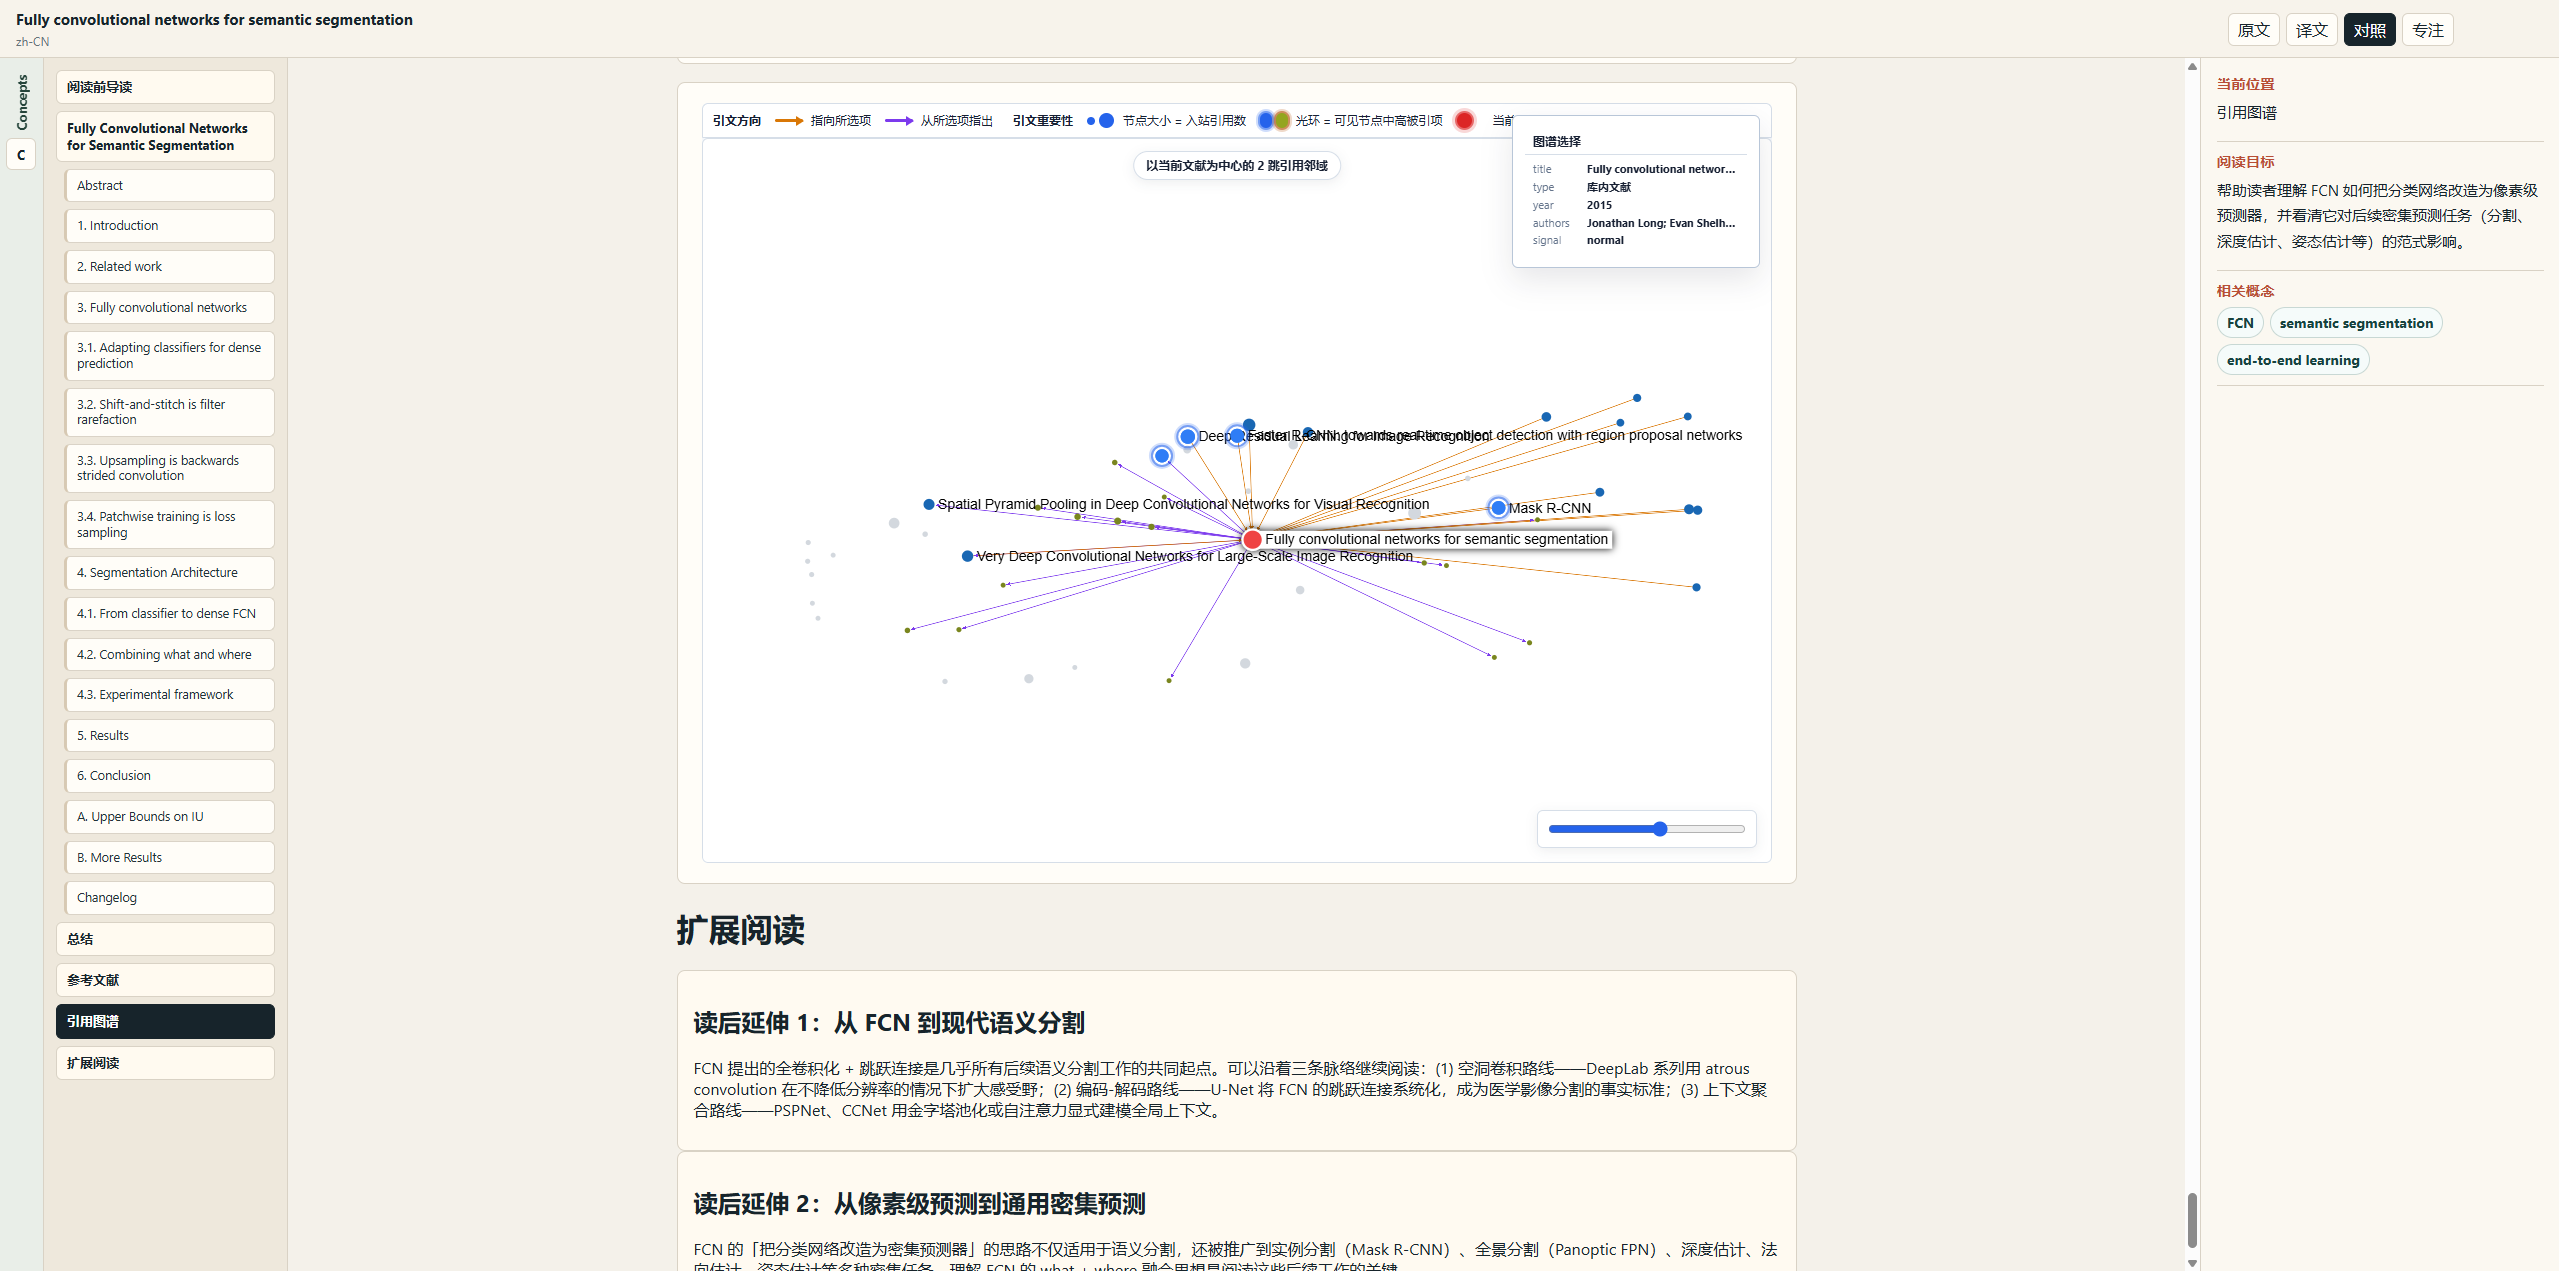
Paramètres
| Paramètre | Type | Description | Défaut |
|---|---|---|---|
target_language | string | Langue cible | zh-CN |
Valeurs disponibles : zh-CN, en-US, ja-JP, ko-KR, de-DE, fr-FR, es-ES, ru-RU. Une saisie personnalisée est également prise en charge.
Dépendances
- Backend : Backend ACP (nécessite la prise en charge du protocole ACP)
- Configuration du Backend : Configurer un backend de type ACP dans le Gestionnaire de Backends
Workflows Associés
- Literature Analysis — Générer automatiquement des résumés littéraires et des analyses de citation
- Interactive Literature Explainer — Dialoguer avec l'IA pour une compréhension approfondie de la littérature